Kategorie: Data Science

  • Wo laufen Sie denn? Customer Journey und Touchpoint Management

    Wo laufen Sie denn? Customer Journey und Touchpoint Management

    (S1/E13) Wenn Sie diese Podcast-Folge gehört haben werden, wissen Sie, was die unterschiedliche Gestaltung von französischen und englischen Gärten mit Ihrem Einkaufserlebnis im Web zu tun hat. Wie beispielhaft angenehm trotz Fernbeziehung zu den Kunden das Shopping im Web gestaltet wird. Sie bekommen in dieser Folge exklusiv einen tiefen Blick in den Regieraum eines Multi-Milliarden Geschäfts.

    In dieser Podcast-Folge geht es um die Gestaltung des Einkaufens im Web. Ein schwieriges Unterfangen – stellen Sie sich vor, Sie stünden zum ersten Mal vor der Frage: Wie mache ich E-Business und an was muss ich alles denken? Als Geschäftsinhaberin eines neuen Ladens aus Ziegeln und Mörtel richtet man seinen Laden ein, sorgt für volle Regale, wirbt um Kunden, schliesst den Laden auf und verkauft live an echte Menschen. Spricht mit Kund:innen, fragt nach Wünschen, berät, nimmt Reklamationen auf, hat eine klare Linie im Kopf und verändert Angebote und Darbietung kundenorientiert. Schliesst des Abends den Laden zu, macht Kasse und Buchhaltung. Bestellt nach.

    Im Web geht’s genauso, nur ohne analoge direkte Kontakte. Und damit wird es schwieriger. Dass diese Art des Verkaufens bereits ihre Vorläufer in Versandunternehmen mit gedruckten Katalogen hat(te), hilft nur bedingt.

    Was weiterhilft, ist die kluge Auswertung von Daten der Besucher. Das generiert zum einen Wissen über die Wege der Kaufenden zum Produkt (auch ausserhalb des Shops), die „Customer Journey“. Und analysiert die Stationen, wo Kunden wirkliche Berührungspunkte zum Produkt und Shop haben, die, so heisst der Fachbegriff, „Touchpoints“. Eine bewusste Gestaltung der Kundenreise und der Berührungspunkte erleichtern Suchen, Finden, sich entscheiden und das Kaufen.

    Stetige Datenanalysen ermöglichen es auch, die Shops zu optimieren, eine höhere Wandlung von Besuchern zu Interessierten und Kaufenden zu erreichen. Diese Conversion ist ein wichtiger Schlüssel, um den Erfolg des E-Business zu messen.

    Eine überraschende Erkenntnis dieser Folge von …achwas?!® ist, dass es für ein gelungenes E-Business sowohl der klaren, übersichtlichen Struktur französischer wie auch der eher überraschenden, zum Entdecken einladenden Gestaltung englischer Gärten bedarf.

    Quellen

    • Wie baue ich ein perfektes Webbusiness? Die 1 Mio. $ Frage beantworten Dutzende von Büchern und Websites. Die Orientierung an den Erfolgreichen kann helfen, aber: Vielleicht haben diese nur zufällig überlebt? Oder sind in drei Jahren schon vergessen.

      Einen guten Ausgangspunkt findet man auf dieser Webseite
      https://www.versacommerce.de/blog/checkliste-webshop

      Und "stay tuned", Sie werden immer wieder Folgen auf "achwasfm.janlucash.com/" zum Thema E-Business / E-Sales / E-Commerce gefunden haben.
    • Touchpoint Management mit fast all‘ seinen Facetten ist ein weites Feld. Eine gute, praxisorientierte Einführung und tiefere Erkenntnisse gib es im Sammelband „Touchpoint Management – Entlang der Customer Journey erfolgreich agieren“ der Herausgeber Bernhard Keller und Cirk Sören. In diesem Band finden sich auch die Checklisten für gelingendes Touchpoint Management. https://www.nymphenburg.de/buecher-items/articles/touchpoint-management.html
    • In seinem Beitrag „‚Kauf, Du Sau‘: Wie Echtzeitwerbung die Kreativität tötet“ beschäftigt sich Dominik Grollmann mit fortgeschrittenen Marketinginstrumenten wie Programmatic Buying und Realtime Advertising (höre Folge 6 von …achwas?! Die andere Google Story). In diesem Zusammenhang fällt auch der zitierte Satz „Kauf Du Sau!“.
      https://www.ibusiness.de/members/aktuell/db/499304grollmann.html

    • Touchpoint Management ist mehr als ein Werkzeug des Verkaufs. Die Analyse der Customer Journey trägt auch zur Produkt- und Service-Entwicklung bei und lässt frühzeitig neue Trends erkennen: “Use Big Data to Create Value for Customers. Not Just Target Them“. Der Forscher Niraj Dawar führt dazu aus, dass der wirkliche Beitrag in der Gestaltung des Nutzungs- und Produktmehrwerts für den Kunden liegt. “Only this will allow marketers to turn data into sustainable competitive advantage“.
      Niraj Dawar, Harvard Business Review vom 16.8.2016.

    Die Geschichte zum Beitragsbild

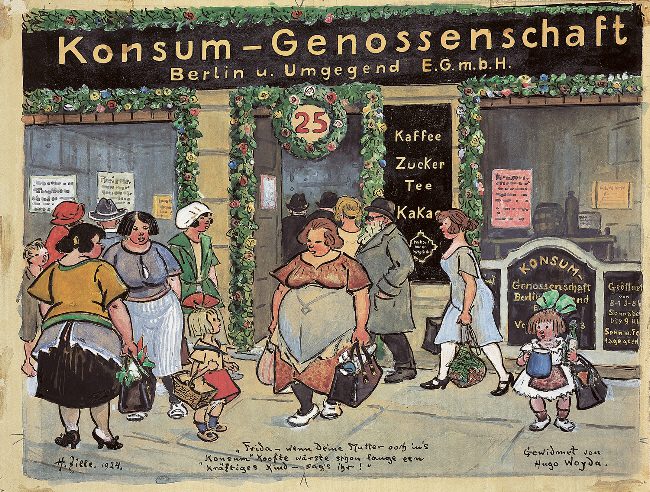
    Heinrich Zilles Zeichnung trägt den Titel: „Konsum-Genossenschaft. „Frida – wenn Deine Mutter ooch in’s „Konsum“ koofte wärste schon lange een kräftiges Kind – sag’s ihr!“ und stammt aus dem Jahr 1924.
    Zille’s „Miljöh“-Bilder sind voller empathischer Präzision, stellen klar, nie bloß und wecken Verständnis für die „kleinen Leute“ im Berlin vor 100 Jahren.
    Für die Betreiber einer E-„Konsums-Genossenschaft“ wären die Menschen auf den Bildern Prototypen und Personas.
    Die Datenströme von Customer Journey und Touchpoint Management erschliessen sich allerdings weniger intuitiv als Zilles Zeichnungen.

    Zur sehr spannenden Geschichte der ungewöhnlichen Berliner „Konsum-Genossenschaft“ gibt es einen umfassenden Artikel in der Wikipedia.
    https://de.wikipedia.org/wiki/Konsumgenossenschaft

    Zilles Bild in der wikimedia:
    https://commons.wikimedia.org/wiki/File:Heinrich_Zille_Konsum-Genossenschaft.jpg?uselang=de
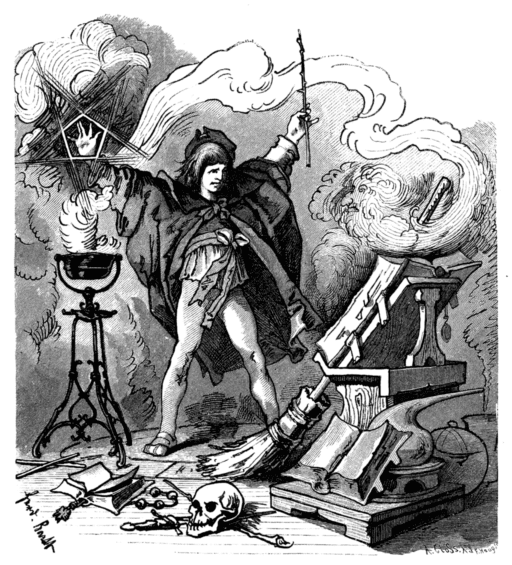
  • Ich sehe nur, was du schon siehst.  Die Lehrjahre der Künstlichen Intelligenz.

    Ich sehe nur, was du schon siehst. Die Lehrjahre der Künstlichen Intelligenz.

    (S1/E08) Als Gespenst geht KI schon lange um. Ist sie inzwischen wirkmächtiger geworden? Künstliche Intelligenz, Artificial Intelligence (KI, AI) werkelt allerorten. Merkt, wenn wir beim Autofahren ermüden. Erkennt unsere Gesichter, wenn wir im Web oder der Stadt unterwegs sind. Hilft, unsere Rchetschrebinug zu korrigieren. Trifft Personalentscheidungen, diagnostiziert Hautkrebs, entscheidet darüber, ob wir einen Kredit bekommen. Und unterstützt Richter dabei, Recht zu sprechen. Wir konfrontieren KI mit MI, der menschlichen Intelligenz. Und fragen: Wie machen das diese Helferlein?

    KI, Folge 1: Am Beispiel „Neuronaler Netze“ beschäftigen wir uns mit der Frage: Wie Intelligent sind diese Nachbildungen des menschlichen Gehirns wirklich? Was können sie? Was fehlt ihnen?

    Man kann es sich einfach machen und behaupten: Ihnen fehlt jede moralische Instanz. Aber – wäre das nicht zu viel verlangt von einer Maschine, die in ihrer einfachsten Form nur versucht, uns nachzuahmen? Der alles mögliche in die Algorithmen gepackt wird, um möglichst exakt  und wiederholbar das zu reproduzieren, was wir schon längst wussten?

    Was das mit Doppelkeksen, heißen Herdplatten und einer ganzen Familie von Denk- und Handlungsinstanzen in unserem Kopf zu tun hat, ist Inhalt dieser Folge.

    Versprochen, das ist der erste Teil, es folgt in loser Folge mehr. Viel Vergnügen.

    https://open.spotify.com/episode/2zbbjskAjdxLp3vJP5Ycgb?si=qf98G4QZQ0-2Cxiol-FWdA

    https://open.spotify.com/episode/2zbbjskAjdxLp3vJP5Ycgb?si=1oqNu2QYSLanJ3_4IyeMQw

    Die Geschichte zum Beitragsbild:

    Unser Episodenbild zeigt eine Illustration von Ferdinand Barth zu Johann Wolfgang von Goethes „Der Zauberlehrling“.

    In der Ballade erzählt Goethe, wie ein Zauberlehrling, in einem unbeobachteten Augenblick einen aufgeschnappten Zauberspruch seines Lehrmeisters ausprobiert.

    Seine Wort und Werke
    merkt ich und den Brauch,
    und mit Geistesstärke
    tu ich Wunder auch.

    Der Lehrling, unerfahren und etwas überheblich, merkte sich nur die Start Sequenz des Spruchs, er selbst kann den einmal angestoßenen Prozess nicht mehr stoppen, der zurückkehrende Meister beendet den Alptraum


    Ach, da kommt der Meister!
    Herr, die Not ist groß!
    Die ich rief, die Geister
    werd ich nun nicht los.

    Die Ballade ist eine Allegorie für die Möglichkeiten von KI und zeigt gleichzeitig deren Gefahren auf:
    Vom Meister abgeschaut bedeutet nicht, von ihm gelernt zu haben.

    https://commons.wikimedia.org/wiki/File:Tovenaarsleerling_S_Barth.png

    Quellen:

    KDnugget.com
    Es gibt viele Anwendungen für Künstliche Intelligenz. Zu Grunde liegen oft Algorithmen, die auch in der angewandten Statistik benötigt werden, vielfach dort entstanden sind. Empfehlung: Auf den Webseiten von KDnuggets gibt es dazu sehr gute Informationen aus erster Hand.
    https://www.kdnuggets.com/2021/07/brutal-truth-data-science.html

    Eine gute Einführung in KI hat Hannah Fry geschrieben: „Hello World“. Sie kennt viele Anwendungen aus eigenr Erfahrung. Sie schreibt dazu: „Das hier ist kein Buch über Algorithmen. Es geht um Menschen. Es geht darum, wer wir sind, wohin wir gehen und was wichtig ist für uns – und wie sich das durch Technologie verändert. Ich verspreche keine fertigen Antworten, aber ich hoffe, das Buch wird Ihre Sicht auf die Welt verändern.“
    Hier die Verlagsseite, auf der sie sich vorstellt:
    https://www.chbeck.de/buehnen/hannah-fry-hello-world/

    Im Beitrag des Deutschlandfunks erfährt man noch mehr
    https://www.deutschlandfunkkultur.de/hanna-fry-hello-world-plaedoyer-fuer-menschliche-algorithmen.950.de.html?dram:article_id=443663

    Wer tiefer in die faszinierende Welt unseres Gehirns eintauchen möchte, dem liefert die folgende Web-Seite gut verständliche Informationen aus medizinischer Sicht (MSD Kompendium)
    https://www.msdmanuals.com/de/heim/störungen-der-hirn-,-rückenmarks-und-nervenfunktion/biologie-des-nervensystems/gehirn?query=Übersicht%20über%20die%20Hirnfunktion

    Dr. Hans Eicher hat in seinem Buch „Die verblüffende Macht der Sprache“ das Gehirn als ein Haus mit drei Stockwerken beschrieben: „Dieses Buch beschreibt die Mechanismen der Sprachverarbeitung im Gehirn …“
    Hier die Verlagsseite.
    https://www.springer.com/de/book/9783658186623

    Oliver Sacks, Der Mann, der seine Frau mit einem Hut verwechselte
    Oliver Sacks macht anhand von Fallgeschichten deutlich, welche gewaltigen Auswirkungen auf unsere Psyche auch kleinste chemische oder physikalische Veränderungen unseres Gehirns haben können.
    Faszinierende Einblicke.
    Hier die Verlagsseite.
    https://www.rowohlt.de/buch/oliver-sacks-der-mann-der-seine-frau-mit-einem-hut-verwechselte-9783499187803

    Last, but not least: Solomon H. Snyders Buch „Die Chemie der Psyche“ ist ein Klassiker (1988). Gut verständlich und fundiert werden die Grundlagen der Stoffwechselvorgänge des Gehirns erklärt: Was Neurotransmitter für unser Denken, Fühlen, Handeln und unsere Psyche bedeutet.
    https://www.amazon.de/Chemie-Psyche-Drogenwirkungen-im-Gehirn/dp/3860251430

  • Suchet und ihr werdet gefunden. Die andere Google Story.

    Suchet und ihr werdet gefunden. Die andere Google Story.

    (S1/E06) Wer suchet, der findet? Sie glauben, schon alles über Google zu wissen? Wir betrachten in dieser Folge den Segen guter Suchmaschinen und blicken unter die Motorhaube von Google. Aber da ist mehr: Die Entwicklung von Google ist eine Parabel für die Entwicklung des Internets. Würde Thomas Mann heute lebend die Geschichte von Google als Prequel zu seinen „Buddebrooks“ schreiben? Als nur Suchende wissen wir wenig, wie die Rechenregeln von Google lauten, um relevante Ergebnisse für unsere machmal schnell hingetippten Eingaben zu finden. Und uns kümmert noch weniger, was Google tut, um unsere Suchen zu finanzieren. Ist ja für uns kostenlos. Oder?

    1995 treffen sich Larry Page und Sergey Brin, um gemeinsam eine Forschungsarbeit zum Thema „Suche im Web“ an der Stanford University zu schreiben. Die Arbeit ist ausgezeichnet und wird zum Patent angemeldet. Larry Page beginnt darüber seine Doktorarbeit – die er nie abschliesst: Der Inhalt ist zu brisant. Sie enthält „die Google Formeln“, die eine Suche effektiv und relevant machen.

    Zum Teil sind diese Formeln immer noch geheim, zum Teil wurden sie „geknackt“. Denn mit dem Erfolg von Google beginnt ein Wettlauf ganz im Sinne eines Räuber-Beute Schemas: Glaubte Google die Finanzierung der Suche über inhaltlich passende „Ads“ (Werbeeinblendungen) sichergestellt zu haben, gab es kluge Köpfe, die rausgefunden haben, wie man, anstatt für Ads zu zahlen, die Webseiten „suchoptimiert“.

    Die Geschichte von Google selbst liest sich wie ein großes Experiment, ein A/B-Testing: So erfindet Google in 26 Jahren immer neue Tarifmodelle, Werbeformate und Tools, um mehr über uns zu erfahren. Und kreiert das Meta-Google Unternehmen Alphabet, eine Art Weltwissen-Maschine.

    Die Geschichte zum Beitragsbild

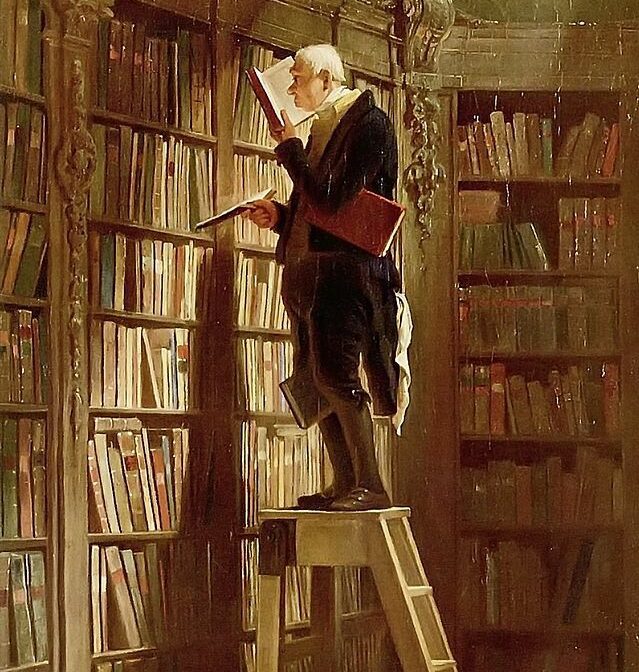
    Das Bild stellt einen Google Vorfahren aus dem 19. Jahrhundert dar: „Der Bibliothekar“ von Carl Spitzweg (um 1850) zeigt einen Suchenden in seiner Bibliothek. Er hat wohl schon Ergebnisse gefunden und versucht gerade einen neuen Text auf Relevanz für sein Thema zu prüfen.

    Gedankenspiel: Wenn dies ein hauptberuflicher Bibliothekar wäre, der nicht für seine Suchen entlohnt würde, finge er vielleicht an, den ausgeliehenen Büchern kleine „Werbezettel“ für die örtliche Metzgerei oder die Pfarrei beizufügen? Würde er sich notieren, wer welche Bücher entleiht, um bessere Empfehlungen zu geben? Oder würde er diese Information an die Apothekerin oder den Lebensmittelhändler verkaufen, um das „Einkaufserlebnis“ der Lesenden „angenehmer“ zu gestalten?

    Carl Spitzweg malte und verkaufte acht zum Teil ähnliche Fassungen des „Bibliothekars“, die erste davon etwa um das Jahr 1845 mit dem bekannteren Titel „Der Bücherwurm“. https://commons.wikimedia.org/wiki/File:Carl_Spitzweg_021.jpg

    Quellen:

    Die Geschichte von Google „in einer Nussschale“
    Die Geschichte von Google ist sehr gut auf Wikipedia beschrieben. Viele der Fakten im Podcast finden sich dort auch – und noch weitergehende Stories und Trivia.
    https://de.wikipedia.org/wiki/Google_LLC

    WDF*IDF
    Diese Formel existiert schon seit 1992 als eine Möglichkeit, Dokumente (auch Websites sind Dokumente) nach relevanten Inhalten in ihrer Bedeutung in eine Rangfolge zu bringen („zu ranken“).

    Der Artikel von Wikipedia ist kurz, weisst auf die Erfinderin, Donna Harman, hin und enthält die Formel. https://de.wikipedia.org/wiki/Within-document_Frequency

    Die folgende Website enthält einen WDF*IDF Rechner für Webseiten.
    Wer immer schon mal das ohne eigenes Programmieren ausprobieren wollte – hier gelingt es. Und erklärt die Formeln gut und verständlich.
    https://www.wdfidf-tool.com

    Zitationsindex
    Der 2. Teil der Google Rechenregeln bewertet die Relevanz der Webseite (wie häufig wird eine Seite zitiert („Backlinks“, „verlinkt“) von anderen Seiten. Diese werden um so höher gewichtet, je bedeutsamer sie sind).
    Wie in der Folge besprochen: Auch dieses Verfahren war in der Wissenschaft schon vor Google bekannt als „Zitationsindex“ von Büchern .
    Um zu zeigen, wie das aussieht, haben wir den Zitationsindex von Donna Harman zu ihrem Buch von 1992 „Ranking Algorithms“ verlinkt. Genau, das ist das Buch, in dem ein Teil der „Gottesformel“ beschrieben steht. Der Link zeigt auf „Google Scholar“, der Google Suchmaschine für wissenschaftliche Texte. Die eben diesen Algorithmus verwendet.
    https://scholar.google.com/citations?view_op=view_citation&hl=en&user=0lic4McAAAAJ&citation_for_view=0lic4McAAAAJ:fQNAKQ3IYiAC

    Sorry, this is „gibberish“!
    Gibberish entspricht den deutschen Ausdrücken „Geschwafel, Gefasel, Geschwurbel“.“… calculating a gibberish score for the resource using the language model score and the query stuffing score; and using the calculated gibberish score to determine whether to modify a ranking score of the resource.“
    Das Google Patent zum Erkennen von „Geschwafel“ befindet sich auf der Website mit den Google Patenten.
    https://patents.google.com/patent/US8554769B1/en

    Dazu passend:
    Die Surprise Website der Woche: mit „Super-Dooper Content inkl. Suchmaschinen Optimierung“
    Ausprobieren: Generiere eine suchmaschinenoptimierte esoterische Webseite mit Text, Bild und Kommentaren. Gibberish auf Knopfdruck. https://sebpearce.com/bullshit/

    Alphabet und alpha-bet: aus einem Brief von Larry Page und Sergey Brin:
    „…For Sergey and me this is a very exciting new chapter in the life of Google—the birth of Alphabet. We liked the name Alphabet because it means a collection of letters that represent language, one of humanity’s most important innovations, and is the core of how we index with Google search! We also like that it means alpha‑bet (Alpha is investment return above benchmark), which we strive for! I should add that we are not intending for this to be a big consumer brand with related products—the whole point is that Alphabet companies should have independence and develop their own brands….“
    https://abc.xyz

    Google Sicherheit Zitat: „Technologie für alle zu entwickeln – das bedeutet auch, alle zu schützen, die sie nutzen. Unsere Datenschutz- und Sicherheitstechnologien schützen nicht nur unsere Nutzerinnen und Nutzer sondern fördern auch Innovationen in der Branche.“
    https://safety.google/intl/de/security/security-leadership/

    FLoC „Google hat seine neue Technologie Federated Learning of Cohorts (FLoC) nun gestartet. Mit dieser sollen die unbeliebten Tracking-Cookies verschwinden und trotzdem zielgerichtete Werbeschaltungen möglich sein. Statt einen einzelnen Nutzer durch das Netz zu verfolgen und seine Interessen aus diesem Profil abzuleiten, sollen die User nun größeren Interessens-Gruppen zugeordnet werden.“
    https://datenschutzbeauftragter-hamburg.de/2021/04/googles-cookie-ersatz-floc-aus-datenschutzsicht-eine-verbesserung/

    https://winfuture.de/videos/Internet/FLoC-So-funktioniert-Googles-Ersatz-zum-unbeliebten-Tracking-Cookie-22581.html

    Zeitgenössisches über „Suchmaschinen“ – was davon gilt heute noch?
    http://www.kommdesign.de/links/suchmaschinen.htm

    kaesekuchen.de gibt es wirklich
    In dieser Folge wird mehrfach die kaesekuchen.de erwähnt. Als URL spontan während der Aufnahme entstanden, um Methoden der Suche zu illustrieren.
    Nun: Es gibt diese Seite wirklich. Ist eine nicht kommerzielle Seite, auf der man viele Käsekuchen Rezepte findet. Der Besitzer (aus Bonn) der Seite hat uns die Verlinkung gestattet. Wie klein ist die Welt…

  • Wir wissen nicht, was sie tun: Maschinelle Autokorrekturen

    Wir wissen nicht, was sie tun: Maschinelle Autokorrekturen

    (Folge 4, 02.07.2021) Autokorrekturen können lustig, lästig und nützlich sein. Aber was passiert, wenn ein Industrie-Scanner Konstruktionszeichnungen, Steuererklärungen oder Dokumente eigenmächtig verändert? Wie kommt es, dass dieser Software Fehler auch Jahre nach der Entdeckung immer noch sein Unwesen in den Geräten treibt?

    Ausgangspunkt dieser Folge sind Scanner, die „halluzinieren“ und Muster erkennen, die es so nicht gibt. Wir begeben uns auf die Spuren von scheinbar intelligenten Produkten und berichten über die Fallstricke der digitalen Transformation unseres Lebens.

    Denn als Nutzer digitalisierter Produkte wie Smartphones, Autos oder Scannern wissen die meisten von uns nicht, wie genau diese funktionieren, welche Algorithmen (Rechenregeln) uns gerade ihre Ergebnisse präsentieren oder in von uns anders gewollte Abläufe eingreifen.

    Und wir kommen auf den Hund – und erfahren, was die Versuche, die unterschiedlichen Hunderassen maschinell auseinander zu halten, mit Scannern, Autos und Smartphones zu tun haben.

    Bildquelle

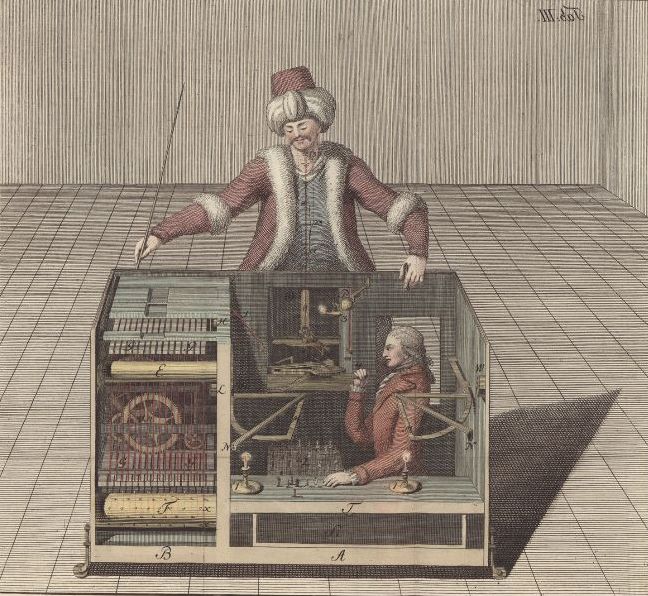
    Das Beitragsbild zeigt ein Wunderwerk der Technik aus dem 18. Jhd. Sein Erfinder, Wolfgang von Kempelen erzeugte bei den Zuschauern den Eindruck, dass dieser Apparat tatsächlich Schach spielen könne. In Wirklichkeit verbarg sich in der Maschine ein Schachmeister, der eine höchst komplexe Maschine bediente. Der Schwindel flog erst spät auf, die Algorithmen waren tief im System verborgen.

    https://commons.wikimedia.org/wiki/File:Racknitz_-_The_Turk_3.jpg

    Quellen

  • Den Fährtenlesern auf der Spur

    Den Fährtenlesern auf der Spur

    (S1/E02)  Am 27. Januar 2018 um 19:24 Ortszeit teilte der 20 jährige Nathan Ruser aus Canbera, Australien, in einem Tweet brandgefährliche Informationen: Auf der frei zugänglichen Landkarte einer Fitness App sind geheime US Militär Standorte deutlich zu identifizieren. Vermeintlich harmlose, anonymisierte Bewegungsdaten zeichnen ein Bild von Laufwegen und Strassennetzen.

    In dieser Folge nimmt …achwas?! selbst die Spur der (un-) heimlichen Fährtenleser auf, die in unseren Apps und im Web werkeln. Wir erzählen, wie wenig es braucht, um sehr viel über uns und unser Leben zu erfahren.

    Unsere Spurenaufnahme führt uns weiter auf die Fährte des kalifornischen Unternehmens SafeGraph*, das wahre Informationsschätze aus wenigen anonymisierten Geolokationen (also Ortung eines Smartphones mit Zeit und Standort) unter Wahrung des strengen kalifornischen Datenschutzes macht. Wie passiert das, ohne irgendwelche persönlichen Daten abzufragen? Wie macht SafeGraph* das, dass die Käufer der Datensätze trotzdem erfahren können, wo Menschen wohnen, einkaufen, ihre Freizeit verbringen, ob sie italienische Restaurants oder den Schnellimbiss bevorzugen, welche Automarke sie fahren – oder ob eher Frauen oder Männer öffentliche Verkehrsmittel nutzen, um ins Büro oder die Fabrik zu kommen?

    Manchmal werden diese Infromationen nicht gekauft, sondern „ge-leakt“, kommen über eine undichte Stelle (Leak) an interessierte Kreise. Ein solches Leak ereilte die Zuhörer der Brand-Rede Donald Trumps vor dem Capitol. Als am 6.1.2021 hunderte Menschen das Capitol erstürmten, hinterließen ihre Smartphones Datenspuren und „petzten“ eine Menge sehr persönlicher Informationen** an die New York Times.

    Anmerkungen :
    *SafeGraph ist nicht im Geltungsbereich der DSGVO (EU) tätig.
    ** Ein Leak dieser Art an die Presse wird durch unsere Datenschutzgesetze und die DSGVO verhindert. Die Nutzung von Geolokationen durch Polizei und Staatsanwaltschaft bedarf eines Richterlichen Beschlusses.

    Die Geschichte zum Beitragsbild: 

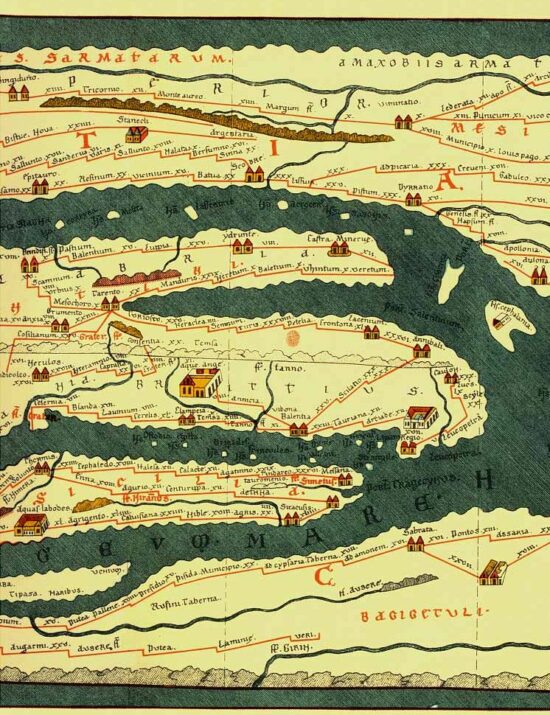
    Wo bin ich – wohin muss ich laufen, reiten, fahren, gehen, um mein Ziel zu erreichen? Unser Wunsch nach Orientierung über unsere Sinne (Auge, Ohr, Tastsinn, Gleichgewichtssinn) und unseres Gedächtnisses bekam schon früh Prothesen durch Zeichnungen und Landkarten. Eine der umfassendsten Landkarten war die Tabula Peutingeriana, deren Original um 345 n.Chr. erstellt wurde. Sie wurde als Wege-, Orts- und Strassenverzeichnis des gesamten Römischen Reichs gezeichnet. Landmarken und Strassen sind nicht massstabgetreu, sondern eher wie die Schemazeichnungen von „London Tube“ oder „Metro Paris“ angelegt.

    Bildquelle: https://de.wikipedia.org/wiki/Tabula_Peutingeriana

    Quellen

    Nathans’s Tweet
    vom 27.1.2018 über geheimnisvolle Spuren auf der Landkarte einer Fitness-App https://twitter.com/Nrg8000/status/957326421684207616

    Mehr über Nathan Ruser
    https://money.cnn.com/2018/01/29/technology/strava-nathan-ruser/index.html

    https://taz.de/Menschenrechtsverletzungen-in-China/!5735542/

    Die Karte der Fitness App STRAVA
    https://www.strava.com/heatmap#7.00/-120.90000/38.36000/hot/allDie Fitness App STRAVA weisst darauf hin, dass die Nutzung als Mapping Tool optional ist.

    SafeGraph Inc. – brilliant, wie man aus Standort, Zeit und Offenen Daten Informationen ernten kann.
    https://www.safegraph.com/blog

    Please Rob Me: Das Projekt ist fast schon als historisch zu bezeichnen (aus dem Jahr 2011), das Problem der Privatheit des eigenen Standorts ist aber heute so aktuell wie damals. Auf der Seite sind durchaus lesenswerte Artikel zum Thema „Locational Privacy“ verlinkt. https://pleaserobme.com/

    New York Times: They Stormed the Capitol. Their Apps Tracked Them.
    Times Opinion was able to identify individuals from a trove of leaked smartphone location data.     https://www.nytimes.com/2021/02/05/opinion/capitol-attack-cellphone-data.html?sara_ecid=nl_upd_1jtzCCtmxpVo9GAZr2b4X8GquyeAc9&nlid=h0s9e6sz

    Bonus Material:

    SPIEGEL ONLINE
    Wo die schöne Welt der neuen Mobilität endet

    Carsharing-Anbieter wie WeShare, Share Now oder Miles meiden ärmere Stadtteile. Dafür fluten sie mit ihren Wagen angesagte Innenstadtviertel – und verschärfen dort manche Verkehrsprobleme, anstatt sie zu lösen.

    https://www.spiegel.de/auto/carsharing-share-now-weshare-miles-und-co-wo-die-welt-der-neuen-mobilitaet-endet-a-5c431f05-95b5-46d9-a24d-27e3dfda0d3c

  • Psychographisches Targeting: Der „Cambridge Analytica“ Skandal

    Psychographisches Targeting: Der „Cambridge Analytica“ Skandal

    (S1/E01) 2010 öffnete Facebook eine Schnittstelle, über die Dritte Profile und Daten der Benutzer*innen aus der Social Media Plattform auslesen konnten. Wenige Jahre später machen sich Psycholog*innen und Data Scientists daran zu demonstrieren, was man anrichten kann, wenn man Persönlichkeitstests („Psychographie“) und Methoden des Online-Marketings („Targeting“) an einer solchen Schnittstelle kombiniert – mit Daten aus 50 Millionen geklauter Profile… Data Science meets Psychology.

    Das Ergebnis der in dem Skandal angewendeten Methoden war im wahrsten Sinn des Wortes weltbewegend, nämlich der „Brexit“ und die Wahl von Donald Trump zum amerikanischen Präsidenten – möglicherweise. Denn: ob und wie stark diese Jahrhundert-Entscheidungen wirklich durch psychografisches Targeting als Propagandawerkzeug beeinflusst waren, wird wahrscheinlich nie ganz aufzuklären sein. In wissenschaftlichen Studien wurde allerdings klar belegt, dass die von dem Unternehmen angebotenen Dienstleistungen, die auf der Durchleuchtung der Persönlichkeit von Personen beruhen sollten, durchaus funktionieren.

    Wir werden über diese Forschungsarbeiten in späteren Beiträgen noch berichten, aber in jedem Fall ist der „Cambridge Analytica Skandal“ eine wahrhaft würdige Geschichte zum Auftakt unseres Podcasts.

    Quellen

    Wer zum Thema Cambridge Analytica recherchiert, kann ob der Menge der Treffer leicht verzweifeln. Die besten Beiträge, die wir zum Einstieg in das Thema empfehlen können, sind diese:

    Die Geschichte zum Beitragsbild:

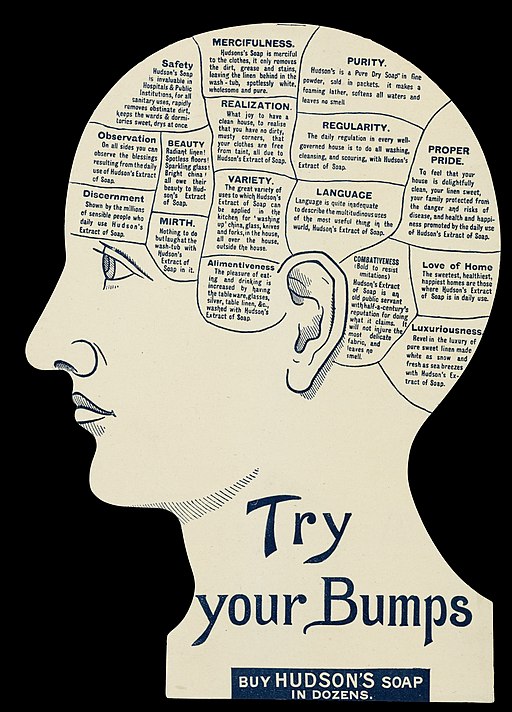
    Die Sehnsucht der Marketing-Spezialisten, aus Hirnforschung und Psychologie magische Rezepte für den Abverkauf von Waren und Dienstleistungen zu entwickeln, wird heute gerne in Neuro-Blabla-Modelle eingepackt. Aber sie ist schon alt. Psychographie und Werbung werden beispielsweise in diesem historischen Poster der Firma „Hudsons Soap“ verknüpft. Es nimmt Bezug auf eine im 19. Jahrhundert weit verbreitete – übrigens völlig falsche – Vorstellung, der zufolge verschiedene Charaktermerkmale in bestimmten Hirnarealen lokalisiert sein sollten. Hiermit eng verbunden war die – übrigens ebenso falsche – Idee, dass man aus der Schädelform auf Charakter von Personen schlussfolgern könnte. „Phrenologie“ war der Name dieser Lehrmeinung, die – ungeachtet ihrer Popularität in der Wissenschaft – nicht mehr als eben dies war (also eine Meinung). In unserem Beitragsbild sind es die Eigenschaften eines wahrhaft wundervollen Seifenpulvers, die mit durchaus ironischem Unterton in unterschiedlichen Hirnarealen angesiedelt werden.
    Bildquelle: https://wellcomecollection.org/works/gs3adbae