S3E08 Es ist eine Kunst, Geschichten so zu erzählen, dass man zuhören will. Die Ausschmückung, manchmal die Grenzgängerin zwischen Fakten und Fiktion, ist eine stete Begleiterin von Geschichten.
Redliche Menschen haben es ein wenig schwerer, die Zuhörenden nicht nur zu fesseln, sondern auch die wahre Geschichte unverfälscht dem neugierigen Publikum anzubieten.
Fake News, aus den Gift-Phiolen von Lüge, Betrug und Niedertracht hergestellt, werden weitere Folgen von achwas beflügeln. Wir erklären.
Diese Folge beschäftigt uns und die Zuhörenden mit der Frage: Wer glaubt denn allen Ernstes offensichtlich "Erfundene Nachrichten", wie naiv, ja leichtgläubig darf man sein? Das es mit einem "Victim Blaming" nicht getan ist und man Menschen damit unrecht tut, zeigen auch weitere Folgen von achwasfm.janlucash.com/.
Keine leichte Geschichte? Doch, versprochen, es gibt so manches Lustiges auf dem Weg zum Verständnis. Das wir auch dank Ihres Mitdenkens auch diesmal erreicht haben werden.
Quellen
Tierkreiszeichen und komplex-menschliches Denken. Das geht nicht zusammen? Mal sehen, sind sie vielleicht im Zeichen der Skeptiker geboren? Leicht zu erraten, wer die leichtgläubigen Tierkreiszeichen sind? www.miss.at hat da bestimmt Ideen.
Der Jugendmedienschutz- Staatsvertrag – ist eine Vereinbarung zwischen allen deutschen Bundesländern und enthält besondere Bestimmungen, die auch die Wirkung von Werbung für Jugendliche und Kinder regeln sollen. Hier zum Download und nachlesen, in der Fassung des Fünften Medienänderungsstaatsvertrages vom 1. Oktober 2024 https://www.die-medienanstalten.de/service/rechtsgrundlagen/jugendmedienschutz-staatsvertrag/
Welche Eigenschaften definieren gesetzlich ein „Kind“?
§ 7 SGB VIII Begriffsbestimmungen (1) Im Sinne des Sozialgesetzbuches Buches ist 1. Kind, wer noch nicht 14 Jahre alt ist, soweit nicht die Absätze zwei bis vier etwas anderes bestimmen, 2. Jugendlicher, wer 14, aber noch nicht 18 Jahre alt ist, 3. junger Volljähriger, wer 18, aber noch nicht 27 Jahre alt ist, 4. junger Mensch, wer noch nicht 27 Jahre alt ist
Die Nachricht in der tagesschau.de, die elektrisierte und Anlass war, die Spur zur Studie von Prof. Götz et al. aufzunehmen: „Wer häufig Fake News glaubt. Stand: 23.04.2025 16:32 Uhr
„Forscher haben 66.000 Menschen befragt, um mehr über ihre Medienkompetenz zu erfahren. Die 12- bis 27-Jährigen konnten Fake News schlecht von Tatsachen unterscheiden. Doch sie waren nicht die Einzigen.
„Die Teilnehmer mussten per Mausklick entscheiden, ob diese Aussagen richtig oder falsch sind. Friedrich Götz ist Assistenzprofessor für Psychologie an der University of British Columbia und leitender Autor der Studie. Er weiß, dass die Hälfte der 20 Meldungen wahr ist, die andere fake.
„Über 66.000 Menschen aus 24 Ländern und fünf Kontinenten haben bei dem Test mitgemacht. Damit ist die Studie eine der weltweit größten. Hauptziel der Untersuchung war, herauszufinden, welche sozialen, demografischen sowie kognitiven Faktoren eine Rolle spielen, um Fake News zu erkennen.
Die Studien zu MIST (Zusammenfassung) Studien 1 – 3. Inn diesen geht es um die Entwicklung eines entsprechenden Diagnostikums: „Leichtgläubigkeit / Anfälligkeit, Fake News zu glauben.“
1. Misinformation Susceptibility Test (MIST): A validated framework and assessment tool to measure misinformation susceptibility, considering veracity discernment and biases.
2. MIST Development and Validation: Three studies with seven independent samples (N=8504) demonstrate the development, validation, and application of the MIST.
3. MIST Applications: Versatile implementations as a screening tool, covariate, and intervention evaluation framework.
Ergebnis: Ein validierter Test The Misinformation Susceptibility Test (MIST): A psychometrically validated measure of news veracity discernment. (Der Misinformation Susceptibility Test (MIST): Ein psychometrisch validiertes Maß für die Wahrnehmung des Wahrheitsgehalts von Nachrichten.)
Der Misinformation Susceptibility Test (MIST): Ein psychometrisch validiertes Maß für die Wahrnehmung des Wahrheitsgehalts von Nachrichten (Aussage der Autor:innen).
In dieser Web-App kann man sein Glück versuchen – bitte selbst entscheiden, ob Sie teilnehmen wollen.
Misinformation Susceptibility Test Statistics – Results
Die Ergebnisse der 66.000er Studie in grafischer Form mit einfacher Bedienung: Explore misinformation susceptibility profiles across 24 countries! Der Link: https://mistest-stats.hf.space
Ergebnisse für Generationen / Deutschland (min = 0, max = 20). Die Unterschiede sind gering.
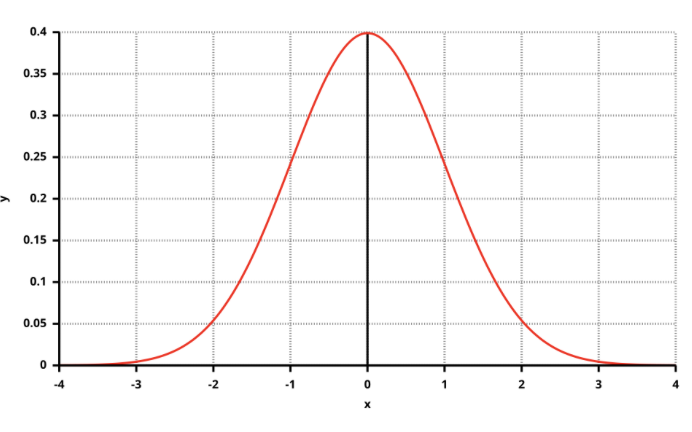
Verteilung über die Merkmale. Wenn die Werte sich rechts „ballen“ oder „knubbeln“, spricht man von einer „links schiefen Verteilung“, die dazu führt, dass man Verteilungen am Rand nicht mehr messen kann. Mehr als nur ein Schönheitsfehler: Normalerweise strebt man im Laufe der Entwicklung eines Tests eine „Normalverteilung“ an (Beispiel „Intelligenztest“, Stichwort Gaus-oder Glockenkurve)).
Die oftmals erwähnte Folge von achwasfm.janlucash.com/, in der die "Mutter der Persönlichkeitstests" vorgestellt wird. Deshalb bekommt die Folge mehr als einen Link, fast schon eine "Bannerwerbung".
Noch mehr Folgen zum Thema enthüllt die Suche hier auf der Website. Dort finden Sie auch Quellen und weiterführende Literatur / Videos zum jeweiligen Thema.
Das Folgenbild
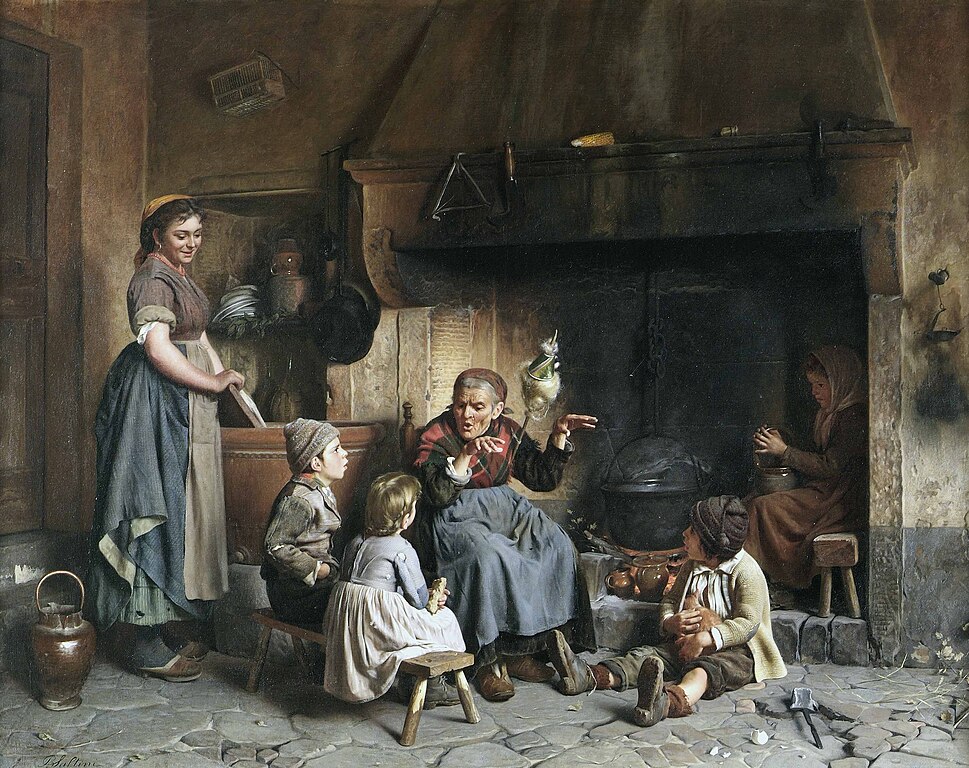
Wie illustriert man solch eine Folge? MIt Wütenden, die reinfielen auf eine „Fake News“? Oder mit den Verführern, die bunte Reden „schwingen“ mit dunklen Gedanken. Wir haben uns für ein Bild entscheiden, das die Wirkung einer spannenden Geschichte perfekt zeigt: Staunend hören Kinder ihrer Nonna (Oma) zu. Sie ist erstaunt, überrascht. Das Bild wurde von Pietro Saltini gemalt und trägt den Titel “ La novella della nonna“ (Großmutters Erzählung) und stammt aus dem Jahr 1875. Pietro Saltini wurde in Florenz geboren im Februar 1839, und starb in Florenz, 1908.
S2/E35. Wie soll denn der KI der Rohstoff ausgehen? Das muss ein Click Bait sein!
Wir leben in einer Welt, die „dataisiert“ durch Digitalisierung ist. Daten sind das neue Öl, stimmt das nicht mehr? Sind die Zeiten von Big Data vorbei? Was haben wir in achwasfm.janlucash.com/ über den Zustand der „Datengruben“ und Förderpumpen bisher verschwiegen?
Der eigentliche Skandal ist nicht, dass es zu wenig Daten gäbe und wir dem verehrten Publikum das verschwiegen hätten. Oder das neue Gesetz von 2023 über Künstliche Intelligenz (AI ACT) Daten verbietet.
Es gibt auch nicht insgesamt zu wenige Daten. Aber von manch lebenswichtigen und überaus notwendigen Daten gibt es zu wenige: In manchen Bereichen, zum Beispiel wenn es um unsere Spezies Mensch geht, fehlt gar die Hälfte, also 50% des Rohstoffs. Die fehlenden Daten wären notwendig, damit wir saubere, valide und zuverlässige KI-Modelle erstellen können.
Denn: Was Daten anbelangt, sind Frauen das „unsichtbare Geschlecht“. Ob in der Forschung von Medikamenten oder auch in der Notfallmedizin, der Produktgestaltung von Alltagsgegenständen oder Fahrzeugen – Frauen, ihre Anatomie, ihr Stoffwechsel, Hormonzyklen – ihre Daten werden nicht erhoben.
Wenn bestimmte Politiker aktuell das Gendern verbieten, geht es um fadenscheinige Propaganda. Wenn sie doch Unternehmen in ihrem Bundesland fragten: Manche sind „mit heißem Bemühn“ damit beschäftigt, lebensrettende Daten zu gendern.
H.W. Klein
Nochmal: Wenn der „Gender Data Gap“ nicht nachhaltig behoben wird, geht der KI „der Saft aus“. Schon jetzt sind KI Modelle unfair und verzerrt und kosten Leben. Das zeigen wir an einem drastischen Beispiel.
Links zu den drei Haupt-Plattformen, auf denen es achwasfm.janlucash.com/ gibt.
… und auf vielen Apps auf dem Lieblings Windows, Android oder iOS Device (AntennaPod, Pocket Casts, Overcast, …)
Die Einbettung von Podcastplayern mit Zugriff auf die entsprechenden Quellen funktioniert nicht immer zuverlässig. Daher finden Sie /findet Ihr an dieser Stelle eine Tabelle mit Links zu den Folgen bei den bekannten Quellen.
Die Quellen
Als Erstes der ALTAI, die Handreichung zum AI ACT: Autoren: AI HLEG – die HIGH-LEVEL EXPERT GROUP ON ARTIFICIAL INTELLIGENCE Titel: „The Assessment List for Trustworthy Artificial Intelligence (ALTAI) for self assessment„
Quellen mit Studien und vielen Beispielen aus der Praxis
Caroline Criado-Perez „Unsichtbare Frauen – wie eine von Daten beherrschte Welt die Hälfte der Bevölkerung ignoriert.„. btb 10.2.2020
Dr. Werner Martens „Gesundheitsrisiko Weiblich – Warum Frauen von der Medizin falsch verstanden und schlechter behandelt werden“ Heyne 26.10.2022
Sonja Sperbera, Susanne Täuber, Corinne Post, Cordula Barzantny: „Gender Data Gap and its impact on management science — Reflections from a European perspective“ European Management Journal 41 (2023) 2–8
> Eine zusätzliche Perspektive: In diesem Artikel werden die negativen Auswirkungen des Gender Data Gap auf die Gesellschaft und das Verwaltungswissenschaft beleuchtet, und aufgezeigt wie der Gap langfristig überwunden werden kann.
„As data increasingly inform every aspect of our lives, gender discrimination in the collection and application of female-based data has also risen. Because data are primarily sourced from (white) men, the solutions we design to address global problems are also primarily based on men, i.e. male bodies, male preferences and prototypical male life choices. The Gender Data Gap – referring to the circumstance that most data on which organisational decisions are based appear to be biased in favour of (white) men – describes this very absence of information about aspects of women’s lives. In this article, we not only demonstrate how the Gender Data Gap (negatively)impacts society and management science, but also highlight how the gap can be overcome in the long run. Further, we showcase several initiatives, particularly European ones, that suggest opportunities to gradually close the Gender Data Gap.“
NHTSA Report: „Newer Cars Appear to Significantly Reduce Gender Disparities in Crash Outcomes“ (08 2022) Zitat: „“Advancing equity, including across our transportation system, is one of the Biden-Harris Administration’s top priorities,” said Dr. Steven Cliff, NHTSA’s Administrator. “While NHTSA’s new report shows significant declines in differences in crash outcomes between women and men, there is more work required to eliminate any disparities that remain.” https://www.nhtsa.gov/press-releases/nhtsa-report-newer-cars-appear-significantly-reduce-gender-disparities-crash
E.V.A. Initiative – Equal Vehicles for All „This initiative is to ensure everyone is represented – not just men, but women and children – when designing for safety. „We believe everyone has a right to be safe. Since 2019, through the E.V.A initiative, we’ve shared over 40 years of safety research. It’s open for anyone to download. Unter dem folgenden Link gibt es diese Daten und Reports https://developer.volvocars.com/resources/eva/reports/#1970-1980
Deutschlandfunk: Wer mehr über den ersten „echten“ weiblichen Crash Test Dummy wissen möchte, kann hier sehen und hören:
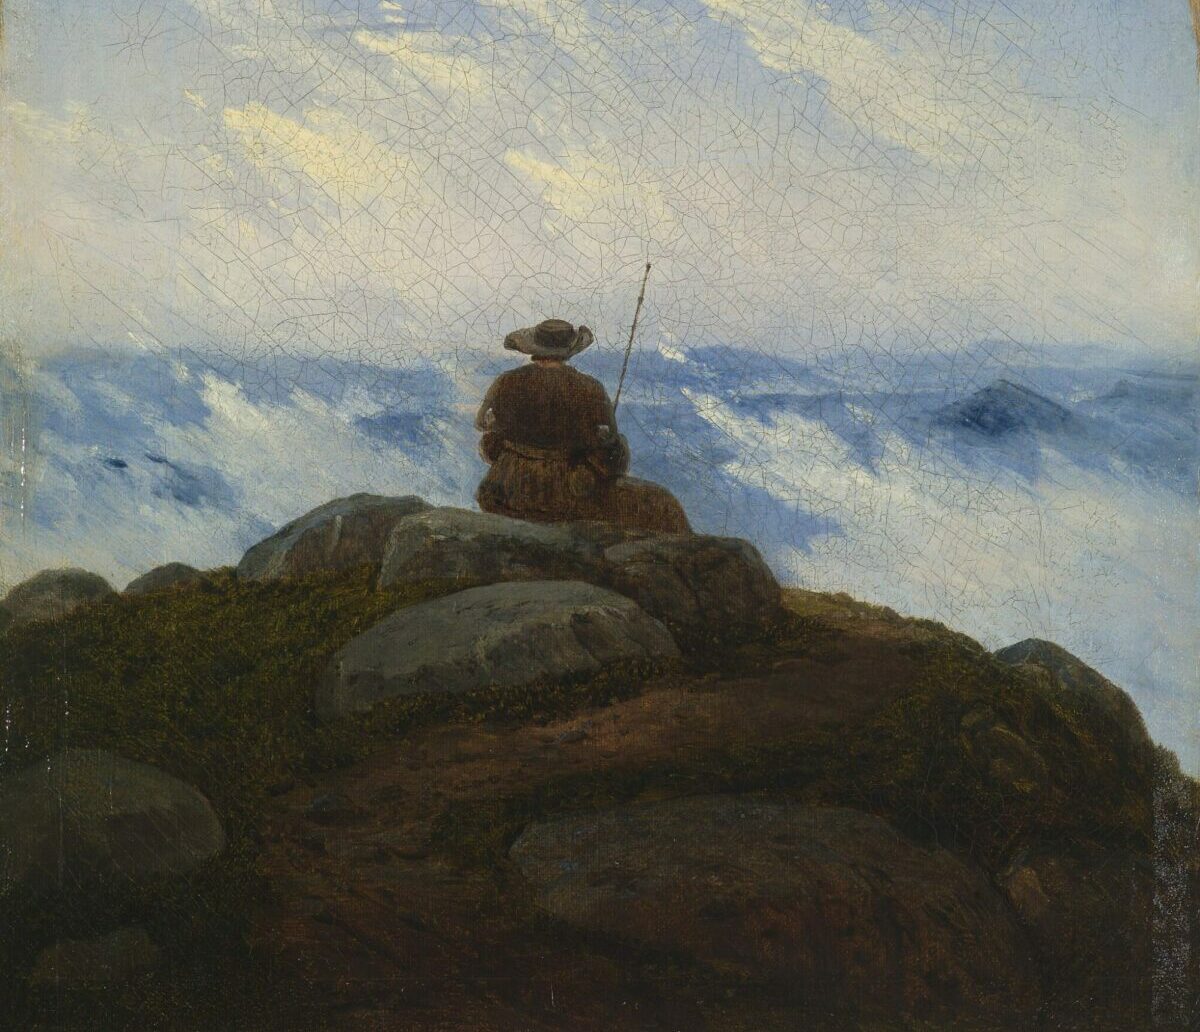
Das Bild zeigt „Die Ruhe des Pilgers / Wanderer auf Bergeshöh„, einen Mann der in ein von Nebel verhülltes Tal schaut. Er kann nur ahnen, was sich dort unten befindet, sein Pilgerstab eignet sich nicht zum Stochern im Nebel oder Fischen im Trüben. Selbst eine KI könnte ihm wahrscheinlich nicht helfen. Es fehlen Daten.
Das Bild stammt von Carl Gustav Carus (1789–1869) und wurde 1818 in Öl gemalt.
S2E27-2 —10.7.2024. Erstveröffentlicht am 22.10.23. haben wir uns mit einem Verdachtsfall von Studienfälschungen mit Auswirkungen beschäftigt: Seit dem 14.3.2024 liegen die Ergebnisse einer forensischen Untersuchung auf über 1.200 Seiten vor, die den Verdacht erhärten. Zum 9.7.24 hat Data Colada veröffentlicht wie die Ergebnisse der eigenen Untersuchungen mit dem Bericht der Experten zusammenpassen. Die Experten geben Data Colada recht und unterstreichen die fachliche Expertise und Sorgfalt.
S2E27-3 17.9.2025 Im Mai 2025 wurde die folgende Nachricht veröffentlicht: „Im Mai 2025 wurden Ginos Amtszeit und Anstellung in Harvard vor Ablauf ihrer zweijährigen Suspendierung im Juni 2025 beendet. Die Hochschule lehnte es ab, konkrete Gründe für ihre Entscheidung anzugeben, erklärte jedoch, dass eine solche Aufhebung der Amtszeit selten sei und seit Jahrzehnten nicht mehr vorgekommen sei.“
Der Fall Beteiligt: Die renommierte Verhaltenswissenschaftlerin – Francesca Gino der Harvard Business School. Sie sah sich diesem Verdacht der Fälschung oder Verfälschung von Daten von Verhaltens-Studien ausgesetzt, die über die Wissenschaft hinaus Einfluss hatten. – Drei Wissenschaftler, die den Blog „Data Colada“ betreiben: Sie erhoben nach einer Recherche schwerwiegende Vorwürfe von Fälschung und Verfälschung von Daten. Ihr übliches und von der wissenschaftlichen Community wertgeschätzte Vorgehen: Sie machen eine Qualitätsprüfung von Studien (nach Hinweisen oder auch im Auftrag als Peer Review). Wenn sie „etwas“ finden, sind die meisten Wissenschaftler froh, dass vor der Veröffentlichung sie Fehler oder Missinterpretationen verbessern können. – Harvard Business School. Im Fall von Frau Gino gab es keine Reaktion. Wie dann üblich informierte Data Colda den Arbeitgeber, im Fall von Frau Gino die Harvard Business School. Diese reagierte (entsetzt) und setzte Forensiker ein, (die mögliche kriminelle Handlungen systematisch untersuchen) um die Vorwürfe zu überprüfen. Daraufhin verklagte Frau Gino Harvard und Data Colada auf 25 Mio$ Schadenersatz wegen übler Nachrede.
Der Experten Bericht liegt nun vor. Pina Colada schreibt dazu am 9.7.2024:
Im Rahmen ihrer Untersuchung verfasste Harvard einen 1.288-seitigen Bericht, in dem die Ergebnisse beschrieben wurden. Aufgrund des Gerichtsverfahrens wurde dieser Bericht veröffentlicht… Und weil er veröffentlicht wurde, wissen wir jetzt, was nach Angaben der Forscher im „ursprünglichen“ Datensatz für eine der vier Studien enthalten war: Studie 3A von Gino, Kouchaki und Casciaro (2020) [1]. Durch einen einfachen Vergleich der Original- und der veröffentlichten Version des Datensatzes können wir genau sehen, wie die Daten verändert wurden, um das veröffentlichte Ergebnis zu erzielen. In diesem Beitrag werden wir das zeigen: … Wir haben korrekt abgeleitet, wie die Daten verändert wurden. Ginos vorherrschende Erklärung für die Veränderungen ist extrem unplausibel.
Quelle https://datacolada.org/118, übersetzt mit DeepL
S2E27: Data in Doubt. Ein Verdacht und die Folgen
Bitte beachtet: Der Fall ist ist aktuell (9.7.2024) auch mit der Feststellung der Forensiker noch nicht abgeschlossen. Bis zum Abschluß gilt die Unschuldsvermutung. Angeklagt im Verfahren dazu sind Data Colada und die Harvard Business School, die Frau Gino ohne Bezüge freigestellt hat.
Wie versprochen: Wir werden neuere Entwicklungen wie die abschliessende juristische Würdigung auf dieser Blog-Site achwasfm.janlucash.com/ berichten.
Chronicle of Higher Education (Der Chronicle bezeichnet sich als „unangefochtener Marktführer im Hochschuljournalismus“ der USA). Er berichtete als erster am 16.Juni 2023 von den Vorwürfen an Francesca Gino. Liste der Artikel zur Causa Francesca Gino https://www.chronicle.com/search?q=gino&s=1
Data Colada Blog. Überprüft Studien, gibt Hinweise, erstellt Tools zum Checken der Daten vor Veröffentlichung. Zur Feedback Kultur: „Our policy is to share drafts of blog posts that discuss someone else’s work with those authors to solicit feedback, 7 days before the posts go live. In an ideal world, researchers will read these drafts and give us feedback about what they think we should change. We don’t want to post anything inaccurate, misleading, confusing, snarky, or poorly worded.“ http://datacolada.org
Website von Francesca Gino Verteidigungsschrift Ihr Statement: „Let that correction begin with this simple and unambiguous statement: I absolutely did not commit academic fraud.„ https://www.francesca-v-harvard.org
Behavioral Scientist: „Harvard Professor Under Scrutiny for Alleged Data Fraud“ 30.8.23. „Amid Uncertainty About Francesca Gino’s Research, the Many Co-Authors Project Could Provide Clarity“ Einordnung, was die Vorwürfe für die Wissenschaftler bedeuten, mit denen Francesca Gino zusammen gearbeitet hat. Und was insgesamt seit dem Bekanntwerden der Vorwürfe in der Verhaltenswissenschaft passierte. https://behavioralscientist.org/amid-uncertainty-about-francesca-gino-led-research-the-many-co-authors-project-could-provide-clarity/
Studie: Vergleich einer Metastudie über Nudging-Erfolge und den Ergebnisse von zwei Real World Nudge Units in den USA (23. Mio. Fälle) Stefano DellaVigna, Elizabeth Linos: „RCTs to Scale: Comprehensive Evidence from Two Nudge Units“ Berkeley Juli 2020 https://eml.berkeley.edu/~sdellavi/wp/NudgeToScale2020-07-06.pdf
Folgenbild
Die Gedanken zum Folgenbild: Auch wenn die Beweislast erdrückend scheint, ist noch kein Urteil gegen Beteiligte ergangen. Bilder von Betrügern, Gauklern, Jahrmarktszauberern schienen uns daher nicht angemessen und oberflächlich. Wir haben uns daher entschieden, ein Bild von Dall*e fabrizieren zu lassen. Ein verlassender Schreibtisch ist die Metapher für die Geschichte, über die wir in dieser Folge berichten. Dall*e vom 23.10.2023, Prompt: „in style of rodin painting of a desktop with paper covered with numbers and pencil in dark room desktop only lit by a desktop lamp“.
S2 E25. Stellen Sie sich einmal vor, sie möchten im Web und mit dem Web Geld “machen”. Richtig viel und dabei den Großen im Web auch in die Parade fahren.
Was könnte das Geschäftsmodell sein, wonach strebt die Wirtschaft – nicht nur im Web? Genau. Daten. Daten sind bekannterweise wie Wind und Sonnenenergie – stetig und unendlich verfügbar und noch besser: Mehrfach verwendbar.
Wobei “Daten” noch kein Geschäftsmodell sind, sondern erst mal beschafft werden müssen, dann rumliegen und Energie verbrauchen – oder verarbeitet werden, möglichst schlau um “was damit zu machen”. Eine Idee muß also her. Oder man hat diese Idee und bschafft die Daten: Eine Idee – die hat Microsoft: sehr wertvolle Daten sind die, die beim Geld verdienen helfen. Im Web wären das genau wie ausserhalb: Daten die Werbung zielgenau werden lassen.
Das Strategische Kochrezept. Man vergleiche sich mit dem Alphatier. Ob die Orientierung an „Best in Class“ jemals jemanden selbst die Nummero 1 werden lies, steht auf einer anderen Page. Dann kauft man sich alles, was das Alphatier hat und versieht es mit magischer Sauce und ist fortan selber der oder die Gejagte? Ob das eine gute Wette sein wird? Wir haben auch für diese Folge genauer hingeschaut und tiefer gegraben, betrachten unter anderem Microsoft, Google und Xandr. Falls Sie die letztgenannte noch nicht kennen: Wir klären Sie auf und betrachten in einem Exkurs dafür eine komplett andere Branche, wo ein ähnliches Kochrezept eine Traumhochzeit zu einer toxischen Arbeitsbeziehung werden lies.
Quellen
Google erklärt, was Google weshalb tut https://about.google/how-our-business-works/
„Wie eng uns Datenhändler auf die Pelle rücken“ heisst der von uns analysierte Artikel von Netzpolitik.org zum Thema Microsoft und Xandr. https://netzpolitik.org/2023/europa-vergleich-wie-eng-uns-datenhaendler-auf-die-pelle-ruecken/ „Für Online-Werbung wollen Datenhändler genau wissen, wie viel Geld wir haben, wie viele Kinder, welche Gebrechen. Unsere große Datenrecherche zeigt die Dimension des brisanten Geschäfts erstmals im EU-Ländervergleich. Fachleute sprechen von einer „Katastrophe“.
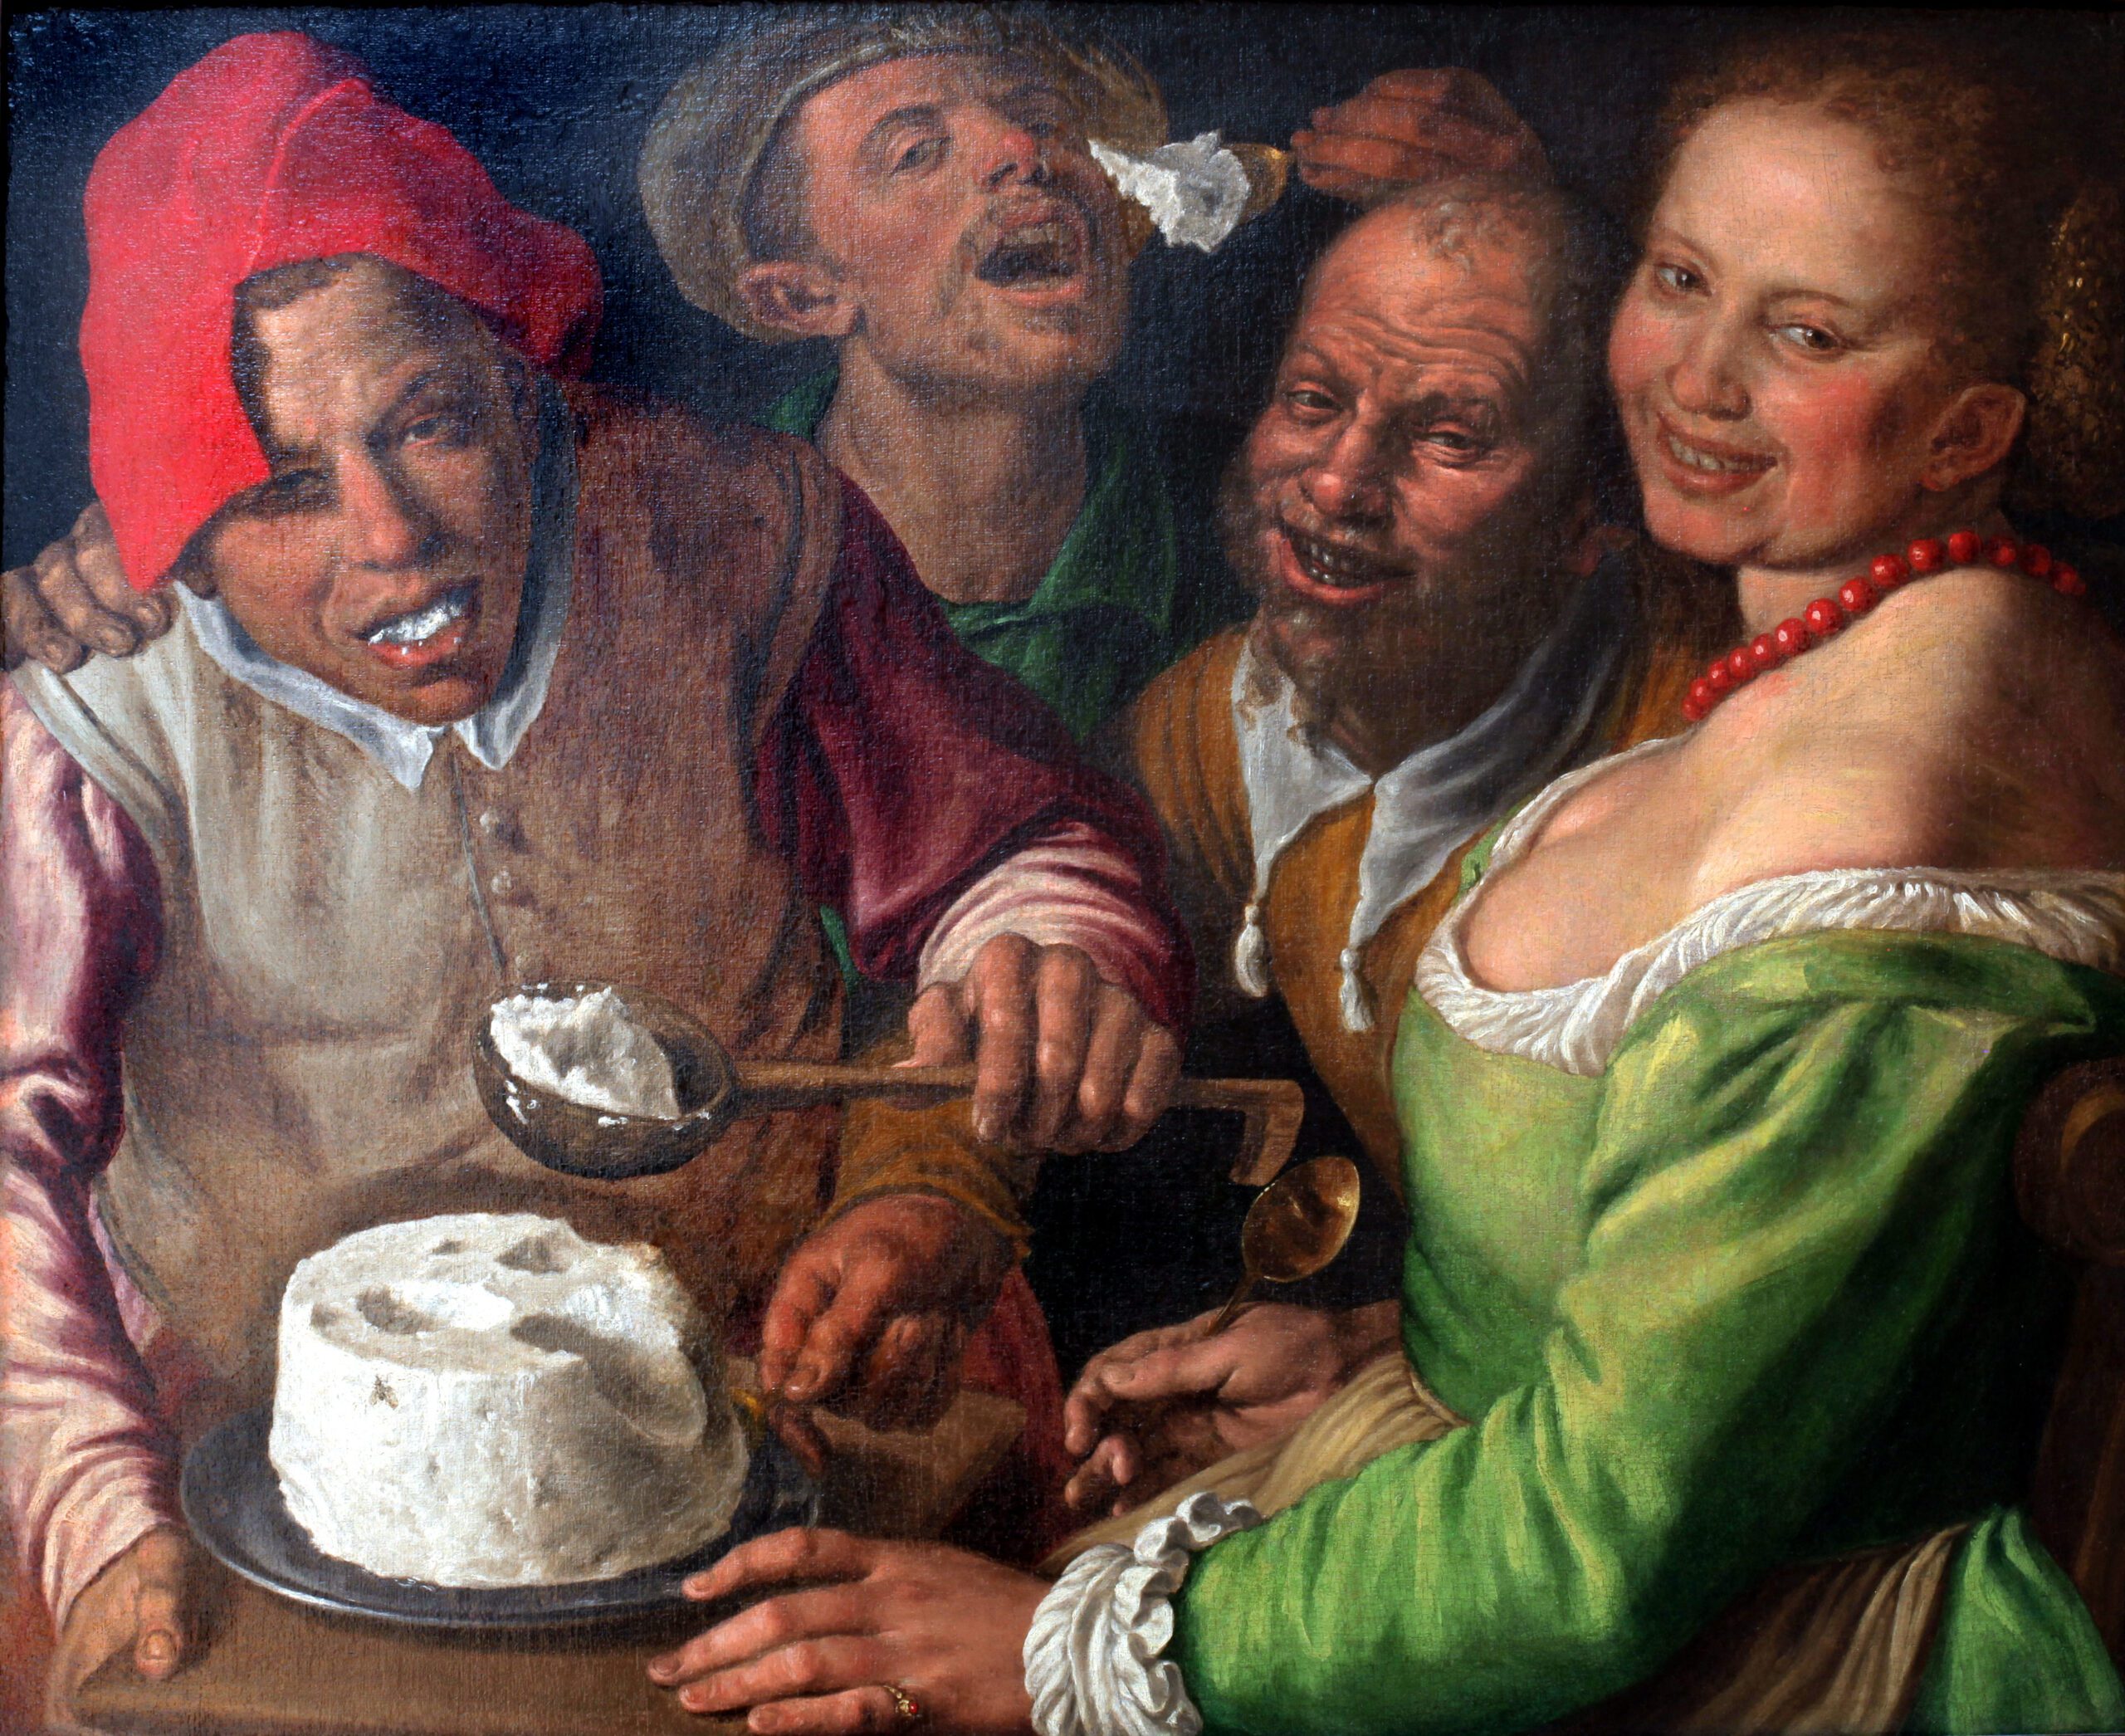
Ein Blick direkt in die Küche der Renaissance. Die Anwesenden scheinen sich gütlich zu tun an einem großen Ricotta und wirken wenig einladend. So als ob sie nichts vom Ricotta abgeben wollten. Da bleibt wohl nichts weiter, als es selbst zu probieren, ein Stück vom Markt, pardon, Käse, zu ergattern.
Das Bild heisst „I mangiatori della ricotta“ (Die Ricotta Esser) und wurde um 1580 gemalt von Vincenzo Campi (1536–1591). Campi war für seine Genre Bilder bekannt, Bilder aus dem Leben der „einfachen Menschen“ ähnlich denen der flämischen Maler, deren Werke bereits einigen unserer Episoden ihre Visualisierung verdanken.
S2/E23 Schon Hänsel und Gretel hatten ihre Probleme mit Keksen oder Brotstücken. Sie sollten ihnen den Weg aus dem Wald weisen, die Krümel wurden allerdings vor dem Einsatz als Wegweiser von den Vögeln aufgepickt. Vielleicht war dieses Märchen, gesammelt von den Gebrüdern Grimm, die Blaupause für ein stetiges Ärgernis im Web: Cookies. Harmlos? Spionagetools? Komfortabel?
Und gibt es was Neues zu Cookies? Diese „Cookie“ Geschichte hinter den Pixeln führt uns vielleicht in ein Tollhaus, zeigt uns aber auf jeden Fall deutlich den stetigen Kampf im Web zwischen unserer Bequemlichkeit und der notwendigen Aufmerksamkeit, um nicht als Teil eines gut gefütterten, profitablen Datensatzes bei einem Databroker in den USA zu landen.
Dabei fing alles so harmlos an, will man uns weissmachen. Kleine Textdateien würden Informationen enthalten die dazu dienten, uns das Einloggen auf unseren liebsten Seiten zu erleichtern. Was auch spürbar richtig war. Weshalb diese „Cookies“ genannt wurden? So genau weiss man es nicht, der Erfinder Lou Montulli erzählt die Geschichte von HTTP Dateien, die beim Laden einer Webseite zur Wiedererkennung genutzt werden und „Magic Cookie“ genannt wurden.
Aus den Cookies wurden über die Zeit Schokoriegel, die in ihrem Inneren mit Schokolade, Creme, Nüssen und Angelhaken bestückt werden könnten. Und ihren wahren Charakter unter falscher Flagge zuckersüß verstecken konnnten.
Aber das schon mal vorweg: Harmlose Textdateien waren es so wirklich nie. Cookies scheinen uns Menschen alledings „schmackhafter“ als wenn wir einen „Datenbankeintrag“ aufgetischt bekämen.
Quellen
AFFILIATE-MARKETING GRUNDLAGEN, METHODEN UND EXPERTENWISSEN Zitat: „Du möchtest Dir ein Affiliate-Business aufbauen oder Dein Geschäftsmodell optimieren? Jan Schusts Standardwerk bietet Dir einen Überblick über wichtige Themen der Branche. Lies exklusiv bei uns einige Auszüge:“ https://www.100partnerprogramme.de/affiliate-marketing/
Zitate aus dem sehr informativen Blog dr-dsvgo.de „Einwilligungsabfragen werden oft als Cookie Popups oder Cookie Tools bezeichnet und als solche angesehen, obwohl dies falsch ist. Noch schlimmer sind Webseiten, die sogenannten Cookie Blocker einsetzen, die alle einwilligungspflichtigen Plugins nachträglich deaktivieren sollen, bis eine Einwilligung vom Nutzer erteilt wurde. Moderne Browser und Ad Blocker blockieren diese Cookie Dienste, die dann wiederum die kritischen Plugins nicht mehr blockieren können.“ https://dr-dsgvo.de/das-ende-der-cookie-blocker-datenschutzfreundliche-browser-und-werbeblocker/?z=393811832&msh=11466&ct=0
Consent Tools aus Sicht der Affiliates mit dem wichtigen Hinweis: Über „Tricks“ gewonnene Einwilligungen können rechtswidrig sein. „Dark Patterns im Consent Management – und warum Sie lieber darauf verzichten sollten „Dark Patterns sind bei der Gestaltung von Cookie-Bannern weit verbreitet. Warum die Nutzer Einwilligung dann allerdings nicht gültig ist, erklären wir hier“. https://usercentrics.com/de/knowledge-hub/dark-patterns-im-consent-management/
Einsatz von Third Party Cookies Zitat: „Cookies von Drittanbietern werden aussterben – da ist sich die Branche mittlerweile einig. Kein Wunder, basieren sie doch auf einer vergleichsweise veralteten Technologie, die nicht zuletzt immer wieder aufgrund ihrer invasiven Wirkung in Frage gestellt wird…“ https://usercentrics.com/de/knowledge-hub/google-ersetzt-floc-durch-topics/
Eine recht vollständige Übersicht zu Affiliate Programmen: Themen, Unternehmen, Provisionen
Data Brokerage – Zahlen und Fakten zu einem interessanten Business Der Markt für Zahlen, Daten, Fakten des Marktes Data Brokerage ist vielfältig. Die Prognosen weichen zum Teil stark voneinander ab. Die folgende Quelle berücksichtigt die Einschränkungen des Datenmarktes mit Consumer Data (Private Daten) und die Ausweitung des Marktes von IoT (Internet of Things: Smart Home, Sensoren, CCTV, Verkehrsdaten, Out Of Home Media (Aussenwerbung) etc. Die im Podcast genannten Umsätze nutzen diese Quelle: „The global data broker market was valued at US$319.030 billion in 2021 and is expected to grow at a CAGR of 7.96% over the forecast period to reach US$545.431 billion in 2028.“ https://www.knowledge-sourcing.com/report/global-data-broker-market
Episodenbild
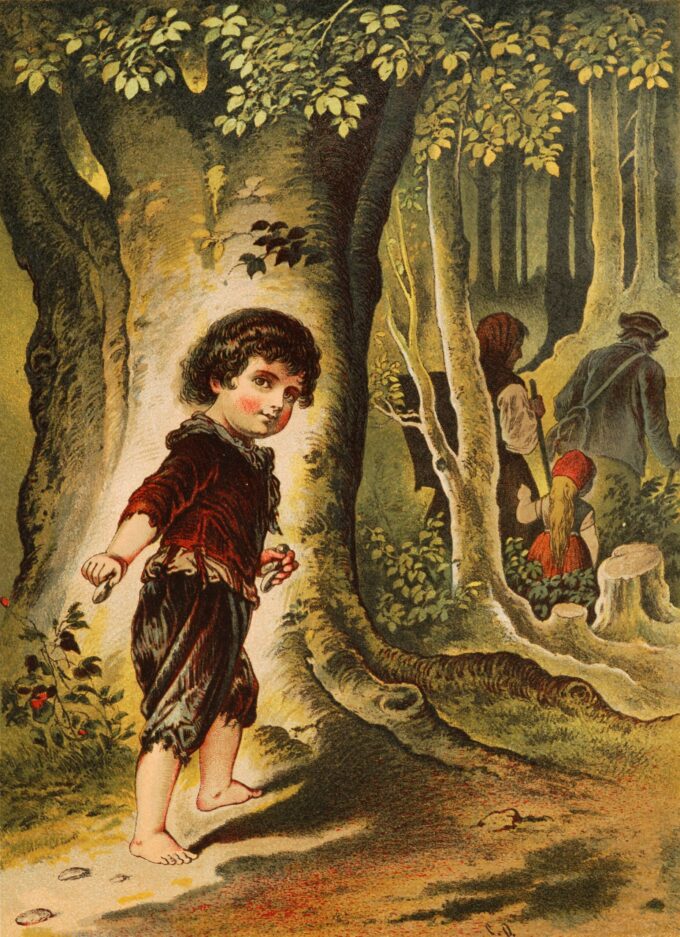
Kaum ein Märchen hat Begrifflichkeiten und Methoden im Web so stark geprägt wie die Geschichte von Hänsel und Gretel*. Bekannt sind die „Breadcrumbs“ in der Navigation auf einer Webseite. Die Krümel helfen uns bei der Orientierung und zeigen, wie wir „hierhin“ gekommen sind.
Wer das Märchen kennt weiß, dass Kieselsteine als permanente Markierungen besser geeignet sind zur „Navigation“.
Das Episodenbild zeigt uns Hänsel, in den Händen jeweils einen hellen Kieselstein. Voller Zuversicht schaut er uns an, diesmal klappt es, den Weg zurück zu finden. Im Hintergrund sieht man Vater, Mutter und Gretel.
Das Bild wurde Ende des 19.Jhds für einen Märchenband von Carl Offterdinger gezeichnet.
*Anmerkung 1: Zugegeben – ich kenne nur „Hänsel und Gretel“ als Märchen, dem ich einen Einfluß auf Bezeichnungen von Web und Navigationsanwendungen in Land-, See- und Luftfahrzeugen unterstellen könnte.
**Anmerkung 2: In der ersten Fassung der Beschreibung habe ich zuerst die Brotkrümel, und dann die Kieselsteine als Navi-Hilfen erwähnt. Richtig ist: Der erste Versuch die Kinder auszusetzen misslang, weil Hänsel Kieselsteine mitführte. Der zweite Versuch wäre fast geglückt. Hänsel hatte nur Brotkrumen mit zur Kennzeichnung des Weges. Sie wären verhungert, wenn sie nicht auf ein Lebkuchenhaus (essbar) gestoßen wären. Insgesamt eine Geschichte voller Gewalt, seitens der Eltern, der Hexe und auch der Kinder.
In der ersten Fake News Folge haben wir ja bereits einige der geradezu wahnwitzigen Geschichten erzählt, die als Fake News verbreitet werden und dabei an der Oberfläche dessen gekratzt, was man als „die Historie der Lügengeschichte“ bezeichnen könnte. Nun ist aber Schluss mit lustig: wir kümmern wir uns um die Wissenschaft! Das ist gar nicht so einfach, denn mittlerweile haben sich Fake News zu einem veritablen Forschungsthema ausgewachsen. Mittlerweile werden jedes Jahr 30.000 Artikel, Bücher, Buchkapitel zum Thema Fake News veröffentlicht.
Dabei ist sicherlich unstrittig – egal in welcher Disziplin – dass Fake News toxisch sind und dass sie eigentlich verboten gehören – ein Sachverhalt übrigens, den der Schöpfer der „10 Gebote“ schon bei ihrem ersten Launch vor mehr als zweitausend Jahren ganz klar auf dem Schirm hatte.
Dass Fake News aber mehr als ein Special-Interest-Thema für Netzaktivisten sind, wird schnell klar, wenn man sich vor Augen hält, welche Disziplinen dabei gerade mitforschen und welche Forschungsfragen dabei jeweils im Mittelpunkt stehen:
Pädagogik – wie kann man Kinder davor schützen, Fake zu glauben?
Medienwissenschaften – wie erreicht man, dass die Wirkung von Fake News neutralisiert werden kann?
Journalismus – welche Regeln sollten Journalist/innen befolgen, welches Verhältnis zur Wahrheit sollten sie haben?
Psychologie – was unterscheidet echte von falschen News, wer ist anfällig, sie zu glauben?
Politikwissenschaften – wie wirkt sich die Flut an Falschinformationen von politischen Akteuren auf die Zivilgesellschaft aus?
Kommunikationswissenschaften – wie funktioniert Propaganda mit Fake News?
Informatik – wie können Fake News durch Skripte und Bots verbreitet werden?
KI-Forschung: kann man Fake News durch maschinelles Lernen identifizieren?
Mindestens einige dieser Fragen werden wir in unserer Folge adressieren und es kann kein Zweifel bestehen, dass die Antworten für uns alle relevant sind. Im Mittelpunkt der Folge steht dabei eine mittlerweile fast schon berühmte Forschungsarbeit aus dem Jahr 2018, in der die Ausbreitungsgeschwindigkeit von Fake News mit echten News verglichen wurde. Und das Ergebnis entspricht ganz klar dem geflügelten Wort…
Eine Lüge ist bereits dreimal um die Erde gelaufen, bevor sich die Wahrheit die Schuhe anzieht.
unbekannt
Obwohl die Herkunft dieses Sinnspruchs nicht wirklich klar ist, wird es gerne wahlweise Mark Twain oder Winston Churchill zugeschrieben. Das wiederum klingt plausibel, ist aber nicht wahr – womit schon einige wichtige Zutaten für eine Fake News vorhanden sind. Einfacher gesagt: Die Fakes sind überall.
Auf eine Wendung unserer Episode möchten wir ausdrücklich hinweisen, mit der wir uns selbst überrascht haben – und die die Idee für ihren Titel gestiftet hat: Neuerdings gibt es ernst zu nehmende Hinweise, dass Menschen, die bereit sind „Bullshit“ zu glauben, besonders anfällig für die Einwirkung von Fake News sind. Bullshit ist dabei nicht einfach dummes Zeug, sondern so etwas wie schwulstiges Geschwätz, dass sich den Anschein von Wichtigkeit und Wissenschaftlichkeit gibt, eigentlich aber ziemlich sinnlos ist. Wir folgen diesem Gedanken und überlegen, was das mit Verschwörungstheorien und ihrem kometenhaften Erfolg in den letzten Jahren zu tun haben könnte…
Der im Podcast erwähnte Überblicksartikel zur Fake-News-Forschung von Catherine Beauvais: Beauvais, C. (2022). Fake news: Why do we believe it?. Joint Bone Spine, 89(4), 105371. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9548403/
Die Aufgaben des Cognitive Reflection Tests wurden in diesem Beitrag verwendet. Sie wurden in diesem Artikel zuerst veröffentlicht: Frederick, S. (2005). Cognitive reflection and decision making. Journal of Economic perspectives, 19(4), 25-42. Online unter https://pubs.aeaweb.org/doi/pdf/10.1257/089533005775196732?TB_iframe=true&
Der Beitrag von Carl Sagan über die Entlarvung schwulstiger Texte (baloney) Sagan, C. (1996). The Demon-Haunted World. Science as a Candle In The Dark. Kapitel 12: „The fine art of baloney detection.“ Online unter http://w3.inf.fu-berlin.de/lehre/WS05/19616-K/materials/Baloney.pdf
Die Studie zum Thema Bullshit und Fake News, die wir am Ende der Podcastfolge erwähnen. Pennycook, G., & Rand, D. G. (2020). Who falls for fake news? The roles of bullshit receptivity, overclaiming, familiarity, and analytic thinking. Journal of personality, 88(2), 185-200. https://onlinelibrary.wiley.com/doi/pdf/10.1111/jopy.12476?
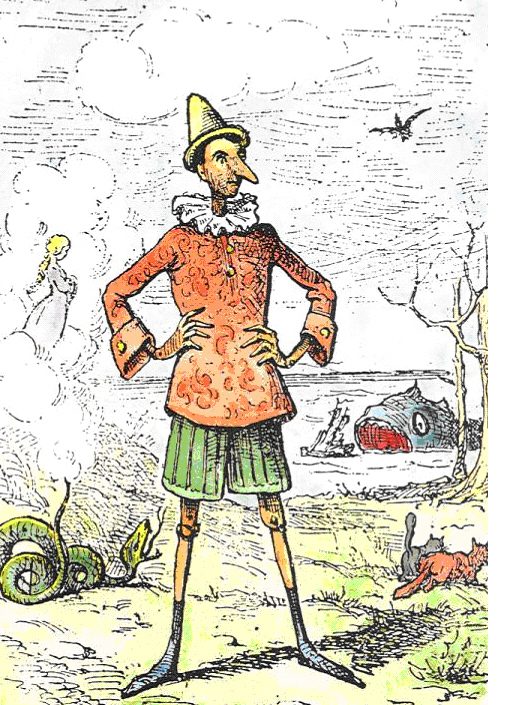
Neben dem Baron Münchhausen gibt es vor allem eine literarische Figur, die als Verkörperung der Probleme, in die man sich mit Lügen verstricken kann, weltweit bekannt geworden ist. Natürlich: wir meinen den berühmten „Pinocchio“ des italienischen Schriftstellers Carlo Collodi. Wir haben allerdings auf die süßlich-dümmliche Variante von Walt Disney verzichtet und gleich auf das Original aus einer der ersten Ausgaben des Pinocchio aus dem 19. Jahrhundert zurückgegriffen. Sie wurde von dem italienischen Techniker und Cartoonist Enrico Mazzanti illustriert und unser Bild wurde aus dem Titel der Ausgabe entnommen: Bildquelle: https://commons.wikimedia.org/wiki/File:Pinocchio.jpg
Ob wir es wollen oder nicht: Der Macht der Kund/innenstimmen in Online-Rezensionen können wir uns kaum entziehen. Dabei zählen nicht nur die vergebenen Sterne, sondern – natürlich – auch die Inhalte. Und sobald auch nur eine einzelne Person, eine von Dutzenden schlechte Erfahrungen mit einem Hotel, einem Bettvorleger, einem Sofa, einem Fernseher, einer Handy-Hülle, einem Auto, einer Wanderreise, einem Zahnarzt gemacht hat, werden wir unwillkürlich irgendwie misstrauisch. Unser alter Bekannter, der Negativity Bias (vgl. achwasfm.janlucash.com/, Folge S1/E30) sorgt dafür...
Dabei sind wir während der Recherchen zu dieser Podcast-Folge auf eine Art Fälschungsindustrie gestoßen. Ein Ökosystem von Dienstleistern, die nichts besseres zu tun haben, als gleich im Dutzend erlogene Rezensionen schreiben zu lassen, um diese dann an ihre Kunden zu liefern. Zielgruppe sind alle, die sich im Netz darstellen oder dort Geschäfte machen wollen (also eigentlich jeder, irgendwie geschäftlich tätig ist. Wir wussten das „im Prinzip“ schon, aber es ist doch ein Unterschied, ob man über theoretische Fälschungen spricht – oder direkt aufgefordert wird, für rund 10 Euro das Stück welche zu bestellen.
Die Folge liegt auf der Hand: Gute Produkte erscheinen also mitunter schlecht, schlechte erscheinen gut, rasch haben wir das Falsche gekauft und das Richtige übersehen – Ätsch, reingefallen! ist man versucht hinzuzufügen. Irgendwie tragisch, wo doch alles so einfach sein könnte, wenn die Welt frei von „Opinion Spam“ wäre (dies ist der Fachausdruck für Lügenrezensionen, auch wenn sie nicht gekauft sind). Nehmen wir ein Beispiel: „Produkt genau wie beschrieben. alles in Ordnung, gerne jederzeit wieder Produkt genau wie beschrieben. alles in Ordnung, gerne jederzeit wieder.“ Was stimmt hier nicht? Nun: Diese Rezension…
… ist unspezifisch und könnte auf jedes Produkt passen
… enthält Wiederholungen („gerne jederzeit wieder“ / alles in Ordnung)
… wurde – etwas, das wir hier nicht sichtbar machen können – mehrfach im gleichen Wortlaut und rasch hintereinander von ein und derselben Person geschrieben
Negative Rezensionen sind noch einmal ein anderes Thema. Aufgrund des menschlichen Wir haben dieser besonderen menschlichen Aufmerksamkeit für negative Informationen schon einem Folge gewidment .
In unserer Podcastfolge kümmern wir uns um verschiedene Facetten dieses Themas:
Was sagt eigentlich das Gesetz gegen den Unlauteren Wettbewerb? Ist das Lügen in dieser Form überhaupt erlaubt? (Erster Spoiler: Nein, ist es nicht. Zweiter Spoiler: Es wird trotzdem gemacht).
Wo und wie findet man welche Firmen, die Fälschungen anbieten und was kostet das?
Wie unterscheiden Wissenschaftler/innen wahre von gelogenen Rezensionen?
Was unterscheidet echte von Fake-Rezensent/innen und Rezensionen?
Der Artikel, in dem beschrieben wird, wie Vergleichsmengen von echten und gefälschten Rezensionen für die wissenschaftliche Arbeit entstehen: Ott, M., Choi, Y., Cardie, C., & Hancock, J. T. (2011). Finding deceptive opinion spam by any stretch of the imagination. arXiv preprint arXiv:1107.4557. Online unter der URL https://arxiv.org/pdf/1107.4557
reviewmeta.com ist das Tool, das Amazon-Rezensionen bereinigt und Daten über die möglicherweise verdächtigen Merkmale von Rezensionen bereitstellt: https://reviewmeta.com/de
Der ultimative Lesetipp für wissenschaftlich Interessierte: Melanie Siegel, Alexa Melpomeni (2020) Sentiment-Analyse deutschsprachiger Meinungsäußerungen – Grundlagen, Methoden und praktische Umsetzung. Springer Verlag. Produktseite des Verlags: https://link.springer.com/book/10.1007/978-3-658-29699-5
Das Episodenbild:
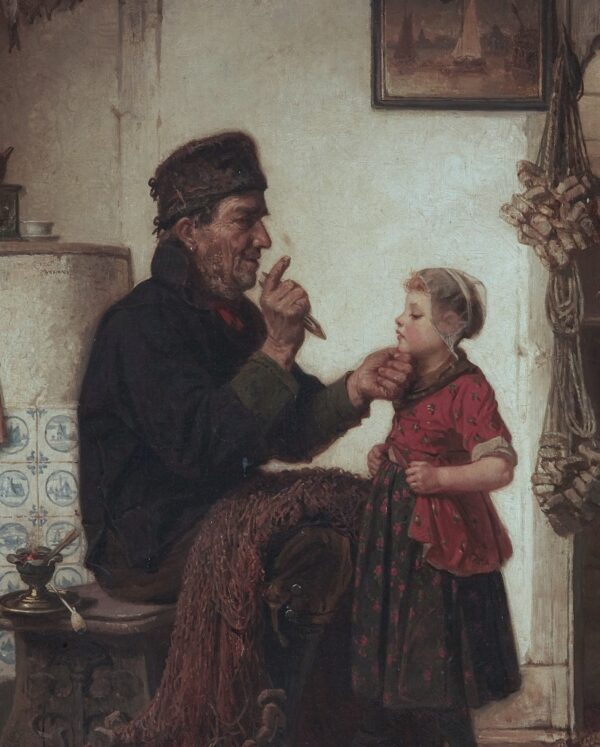
Kann man Lügen malen? Wir waren skeptisch, als wir uns auf die Suche nach einem passenden Epidodenbild begaben. Aber wir hatten Glück: Der Düsseldorfer Maler Rudolf Jordan war in der zweiten Hälfte des 19. Jahrhunderts ein arrivierter Künstler aus Düsseldorf mit Professur und allem drum und dran. Er war auf Nordsee-Szenen spezialisiert und malte ein Bild mit dem Titel „Die erste Lüge“. Ein erwischt ein Mädchen beim Lügen. Wir fanden die Szene als „Meme“ für die Lüge sehr gelungen. Hier verlinken wir das Original – das auf wikiart.org merkwürdigerweise mit dem Titel „Fischer flicken ihre Netze“ versehen ist (wir vermuten einen Fehler, denn man sieht nur einen Fischer und das Flicken der Netze ist Nebensache):
(S2/E09) Jeder Mensch lügt, glauben Sie nicht? achwasfm.janlucash.com/ ist auf Entdeckungsreise: Wir holen Zeugen und Zeugnisse an Bord. Beschäftigen uns mit der wichtigen Idee, wer denn die Wahrheit über menschliches Verhalten dringend braucht, ob Wahrheit Kitt oder Klebstoff unseres Zusammenlebens ist. Als Quellen für die Suche nach der Wahrheit über unsere Spezies kommen medizinische und psychologische Forschung in Betracht. Wir stellen vor, welche Anstrengungen unternommen werden, um deren Qualität zu verbessern.
Sind wir selbst eigentlich in der Lage, wahrheitsgemäß Auskunft über uns zu geben? Dieser Frage widmen sich Veröffentlichungen zweier Unternehmen. Sie lassen uns teilhaben an den Erkenntnissen, die das Web liefern kann.
Stimmt denn die Schlussfolgerung von Google, dass die Analyse der Suchen „unsere dunkelsten Geheimnisse enthüllt“, weil jedermensch lügt?
Oder liegt die Dating-Plattform OkCupid eher richtig, die mit einem Augenzwinkern titelt: „Wer wir sind – wenn wir denken, dass niemand zuschaut?“.
Wir stellen und beantworten die Frage, ob diese Big Data Analysen gedacht sind, oder zumindest genutzt werden können, das Wissen über uns Menschen und unser Verhalten auch im wissenschaftlichen Sinne zu mehren. Oder nur vermittelt werden soll, dass unser Verhalten, als Big Data gesammelt, eher Futter für erschreckendes Clickbait oder auch Big Brother ist.
Quellen
Anmerkung: Der im Podcast erwähnte Ford war der Edsel – eine Automarke, die von Ford 1957 eingeführt wurde, und aus vielerlei Gründen scheiterte. Eigentlich ist die Geschichte eine ganze Folge wert. Robert Daines hat diese Industriegeschichte niedergeschrieben. Robert Daines: „Edsel – The Motor Industry’s Titanic„. Academic Books 1994 In Wikipedia finden Sie eine längere Ausführung zum Thema https://de.wikipedia.org/wiki/Edsel abgerufen 7.1.2023
Ein Klassiker zum Thema: Julia Shaw: „Das trügerische Gedächtnis. Wie unser Gehirn Erinnerungen fälscht„. Aus dem Englischen. Hanser Verlag München 2016
Und noch ein Klassiker, ein Sammelband von: Paul Watzlawick (Hrsg.): „Die erfundene Wirklichkeit. Wie wissen wir, was wir zu wissen glauben? Beiträge zum Konstruktivismus“ Piper Verlag München 1985 (4. Auflage 2008)
Medizinische Forschung
Artikel von Paul Glasziou und Iain Chalmers: „Is 85% of health research really “wasted”?“ Mit weiteren Quellen zur Metastudie inkl. Kritische Analysen in: https://blogs.bmj.com/bmj/2016/01/14/paul-glasziou-and-iain-chalmers-is-85-of-health-research-really-wasted/ abgerufen 2.1.2023 Zitat:“If research was a transport business, we would be appalled by these data. Half the goods carried would be badly designed, half lost in shipping, and half of the remainder broken by the time they arrived—a truly heart breaking waste. The “good news” is that there is vast potential gain from salvage operations! Either rescuing sunken trials from the bottom of the ocean, or repairing the damaged ones, might retrieve up to 75% of the waste (we cannot retrospectively fix poor design).“
Kampagne von The Lancet zur Verbesserung der Qualität medizinischer Forschung: The Lancet REWARD (REduce research Waste And Reward Diligence) Campaign invites everyone involved in biomedical research to critically examine the way they work to reduce waste and maximise efficiency. abgerufen 2.1.2023 https://www.thelancet.com/campaigns/efficiency
Psychologische Forschung
Nuijten, M.B., Hartgerink, C.H.J., van Assen, M.A.L.M. et al. The prevalence of statistical reporting errors in psychology (1985–2013). „The prevalence of statistical reporting errors in psychology (1985-2013)“ Abstract und weitere Studien. abgerufen 2.1.2023 https://pubmed.ncbi.nlm.nih.gov/26497820/
Nuijten, M.B., Hartgerink, C.H.J., van Assen, M.A.L.M. et al.The prevalence of statistical reporting errors in psychology (1985–2013). Behav Res 48, 1205–1226 (2016). Ursprüngliche Veröffentlichung. abgerufen 2.1.2023 https://doi.org/10.3758/s13428-015-0664-2
Big Data is it?
OkCupid erklärt Verhalten
Christian Rudder: „Dataclysm: Who We Are (When We Think No One’s Looking)“, 2014 „Our personal data has been used to spy on us, hire and fire us, and sell us stuff we don’t need. In Dataclysm, Christian Rudder uses it to show us who we truly are.“
Interview mit Christian Rudder, Data Scientist und Co-Founder der Partnerbörse OkCupid https://mixpanel.com/blog/christian-rudder-on-okcupid-user-data-and-the-impending-ai-takeover/ abgerufen 2.1.2023
Tonnen von Data – Kaggle hat sie alle (fast). Datensätze zum Üben, Hypothesen testen, Spielen https://www.kaggle.com
Hier findet man die Quelle für die Anekdote von Thomas Wirth – der MMPI mit eingebauter „Lügen-Skala“: „MMPI (Minnesota Multiphasic Personality Inventory) ist das am weitesten verbreitete und am besten erforschte klinische Beurteilungsinstrument, das von psychiatrischen Fachkräften zur Diagnose von psychischen Störungen eingesetzt wird„. Quelle siehe Link zum Abschnitt, übersetzt aus dem Englischen.
The L Scale: Die L-Skala: Die auch als Lügen-Skala bezeichnete Validitätsskala für „seltene Talente“ wurde entwickelt, um Versuche von Personen zu erkennen, sich selbst in einem günstigen Licht darzustellen. Menschen, die auf dieser Skala eine hohe Punktzahl erreichen, versuchen bewusst, sich so positiv wie möglich darzustellen und weisen Defizite oder unvorteilhafte Eigenschaften auf.) https://www.verywellmind.com/what-is-the-minnesota-multiphasic-personality-inventory-2795582#toc-mmpi-test-validity-scales
Das Episodenbild
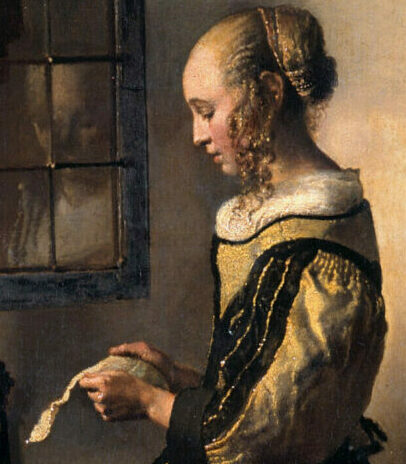
Jan Vermeer hat das Gemälde „Briefleserin am offenen Fenster“ von 1657 bis 1659 erschaffen. Bis 1979 war das Original verschwunden – und hing doch in den Museen direkt vor den Augen des Publikums. Wie das geht? Das erste Bild ist eine – nicht von Jan Vermeer – veränderte Fassung, in der das „Bild im Bild“ eines Cupido (Liebesgott / Amor) fehlt. Das zweite Bild ist das Original, wie es 1979 beim Röntgen entdeckt wurde. Die Untersuchungen zeigten, dass der Cupido im 18.Jhd. – in Paris – übermalt wurde. Im Jahr 2017 wurde dann durch Restaurierung der Originalzustands wieder hergestellt. Ab September 2021 ist das Bild nach fast 300 Jahren wieder „wie neu“ öffentlich zu sehen: Genaue Analysen helfen, das „Big Picture“ wieder zu ent-decken.
Jan Vermeer: Briefleserin am offenen Fenster 1659 (übermalt)Jan Vermeer: Briefleserin am offenen Fenster 1659 (Original)
(S2/E07) Gehören Sie auch zu den langweiligen, für Geheimdienste und fremde Staaten uninteressanten Menschen? Und auch Ihre Nutzung von Social Media oder Streaming Diensten kann und darf jeder und jede sehen? Und doch bleibt ein leichtes Grummeln – da könnte ja was dran sein, an den Warnungen vor Big Data Datenanalysen, die manchmal mehr über Sie wissen als gute Freunde oder gar Ihr Mann oder Ihre Frau?
In dieser Folge beschäftigen wir uns ausschliesslich mit einer einzigen Studie, die zudem eine gewisse Bekanntheit erlangt hat: Das „Spiegel Mining“ von David Kriesel.
Über drei Jahre hat er seine Crawler, flinke unermüdliche Software-Datensammler, nach Stundenplan Informationen von der Spiegel-Online Website “saugen” lassen. Alles legal und legitim, nicht belästigend.
Was er rausfindet gehört in die Kategorie: Hätten Sie’s gewusst? Oder besser noch: „Du ahnst es nicht” Wir klären auf, was man so braucht, um ein Mining durchzuführen.
Und übrigens: Das Thema Datamining kann auch zum Informationssammeln genutzt werden für Firmenrepräsentanzen im Web. Manchmal gibt man mehr preis, als man will. Auch für Firmen eine lohnenswerte Folge.
Das Episodenbild
Das Bild zur Folge wurde von einer künstlichen Intelligenz namens DALL-E erzeugt. Es trägt passenderweise den Titel „Du ahnst es nicht!“. Es wurde von der KI aus der Phrase/ dem Prompt: „impressionist style painting „3 persons in the garden say_ you do not guess!“„,
Phrase, Prompt und Auswahl von Hans-Werner Klein. 12/2022 Mehr zu DALL-E in der achwasfm.janlucash.com/ Podcast-Folge "Was weißt Du über Clickbait…?" S2/E06.
(S1/E41) Vor 9 Jahren, im Juni 2013 wurden Dokumente veröffentlicht, die das World Wide Web, unsere Kommunikation, das Leben, Digitale Unternehmen, Staaten nachhaltig … hätten erschüttern können. Zumindest unsere Sicht auf die Sicherheit unserer persönlichen Informationen, für immer verändern sollen. Eigentlich.
In dieser Episode von achwasfm.janlucash.com/ erzählen wir die Geschichte von Aufklärung im doppelten Sinne: Aufklärung als militärische Aktionen, um Daten über Tun und Lassen eines Widersachers zu erlangen – und die Aufklärung darüber, dass diese Aktionen auch befreundete Staaten, sogar die Bewohner des eigenen Landes betreffen. Und Unrecht sind.
Nach dem 2. Weltkrieg breiteten die als 5-Eyes bezeichneten Staaten USA, Großbritannien, Kanada, Australien und Neuseeland ihr weltweites Spionagenetzwerk aus. Der Kalte Krieg benötigte Informationen über die Sowjetunion – aber auch über die Politik, Politiker und Einwohner westlicher Staaten, die vielleicht mit Wohlwollen oder gar als Agenten diesen Staat unterstützen. Als der Kalte Krieg unter Gorbatschow 1991 mit dem Zerfall der Sowjetunion endete, schienen die „Dienste“ fast schon abgeschrieben. Der 11.9.2001 (9/11) änderte diese Einstellung: Globaler Terrorismus hieß das Ziel der Aufklärung. Ab 2009 bekam ein externe Mitarbeiter der NSA, Edward Snowden, Zugang zu als top secret eingestuften Daten. Was er entdeckte, erschütterte ihn. Es breitete sich eine Struktur von Überwachung und Einflussnahme durch die Geheimdienste der westlichen Welt aus. Die Werkzeuge PRISM und XKeyscore ermöglichten das Sammeln von Daten im Web und die Auswertung dieser Daten.
Edward Snowden entschied sich, diese Informationen zu veröffentlichen, er war sich bewusst, dass er damit zum Staatsfeind in den USA wurde.
Was haben wir aus den Veröffentlichungen gelernt? Was hat die Überwachung genutzt? Was nützt Aufklärung? Mehr dazu im Podcast.
„Wie US-Geheimdienste Daten aus der EU abgreifen könnten“ titelt netzpolitik.org in einer Beitrag vom 26.1.2022 und zitiert aus einem Gutachten: „Das Datenschutzrecht der EU schützt wohl nur bedingt vor US-Geheimdiensten. Ein Gutachten für die Datenschutzkonferenz von Bund und Ländern zeigt: Selbst wenn die Server in der EU stehen, können sensible Daten gefährdet sein.“ (abgerufen am 10.6.2022, 23:42) https://netzpolitik.org/2022/gutachten-veroeffentlicht-wie-us-geheimdienste-daten-aus-der-eu-abgreifen-koennten/
Episodenbild
Unser Episodenbild der Folge 41 trägt den Titel: Windsor Castle, und ist eine Buch-Illustration von E. W, HASLEHUST 1910, Verlag Blackie and son, limited. 1910
PRISM und XKeyscore waren in der Zeit, als unser Episodenbild entstand, eher ein Wachturm mit weitem Ausblick und „Human Brain“ als Auswertungssoftware. Auch die Menschen in einem Wachtturm hatten die Aufgabe, zu beobachten, feindliche Truppen zu erkennen und zusammen mit den Wachen „am Boden“ suspekte Personen zu überprüfen. Über die Algorithmen dieser Wächter ist eher wenig bekannt.