Kategorie: Technik

  • Gender Data Gap. Geht KI der Rohstoff aus?

    Gender Data Gap. Geht KI der Rohstoff aus?

    S2/E35.  Wie soll denn der KI der Rohstoff ausgehen? Das muss ein Click Bait sein!

    Wir leben in einer Welt, die „dataisiert“ durch Digitalisierung ist. Daten sind das neue Öl, stimmt das nicht mehr? Sind die Zeiten von Big Data vorbei? Was haben wir in ⁠achwasfm.janlucash.com/⁠ über den Zustand der „Datengruben“ und Förderpumpen bisher verschwiegen?

    Der eigentliche Skandal ist nicht, dass es zu wenig Daten gäbe und wir dem verehrten Publikum das verschwiegen hätten. Oder das neue Gesetz von 2023 über Künstliche Intelligenz (AI ACT) Daten verbietet. 

    Es gibt auch nicht insgesamt zu wenige Daten. Aber von manch lebenswichtigen und überaus notwendigen Daten gibt es zu wenige: In manchen Bereichen, zum Beispiel wenn es um unsere Spezies Mensch geht, fehlt gar die Hälfte, also 50% des Rohstoffs. Die fehlenden Daten wären notwendig, damit wir saubere, valide und zuverlässige KI-Modelle erstellen können.

    Denn: Was Daten anbelangt, sind Frauen das „unsichtbare Geschlecht“. Ob in der Forschung von Medikamenten oder auch in der Notfallmedizin, der Produktgestaltung von Alltagsgegenständen oder Fahrzeugen – Frauen, ihre Anatomie, ihr Stoffwechsel, Hormonzyklen – ihre Daten werden nicht erhoben.

    Wenn bestimmte Politiker aktuell das Gendern verbieten, geht es um fadenscheinige Propaganda. Wenn sie doch Unternehmen in ihrem Bundesland fragten:  Manche sind „mit heißem Bemühn“ damit beschäftigt, lebensrettende Daten zu gendern.

    H.W. Klein

    Nochmal: Wenn der „Gender Data Gap“ nicht nachhaltig behoben wird, geht der KI „der Saft aus“. Schon jetzt sind KI Modelle unfair und verzerrt und kosten Leben. Das zeigen wir an einem drastischen Beispiel.

    Links zu den drei Haupt-Plattformen, auf denen es achwasfm.janlucash.com/ gibt.

    Die Einbettung von Podcastplayern mit Zugriff auf die entsprechenden Quellen funktioniert nicht immer zuverlässig. Daher finden Sie /findet Ihr an dieser Stelle eine Tabelle mit Links zu den Folgen bei den bekannten Quellen.

    Die Quellen

    Als Erstes der ALTAI, die Handreichung zum AI ACT:
    Autoren: AI HLEG – die HIGH-LEVEL EXPERT GROUP ON ARTIFICIAL INTELLIGENCE
    Titel: „The Assessment List for Trustworthy Artificial Intelligence (ALTAI) for self assessment„

    Die im Januar 2024 aktualisierte Homepage des ALTAI (Download des ALTAI auch in deutscher Sprache möglich. Kostenlos).
    https://digital-strategy.ec.europa.eu/en/library/ethics-guidelines-trustworthy-ai

    Hier kann man den ALTAI online ausfüllen https://altai.insight-centre.org/Home/HowToComplete

    Quellen mit Studien und vielen Beispielen aus der Praxis

    Caroline Criado-Perez „Unsichtbare  Frauen – wie eine von Daten beherrschte Welt die Hälfte der Bevölkerung ignoriert.„. btb 10.2.2020 

    Dr. Werner Martens „Gesundheitsrisiko Weiblich – Warum Frauen von der Medizin falsch verstanden und schlechter behandelt werden“ Heyne 26.10.2022

    Sonja Sperbera, Susanne Täuber, Corinne Post, Cordula Barzantny: „Gender Data Gap and its impact on management science — Reflections from a European perspective“
    European Management Journal 41 (2023) 2–8

    > Eine zusätzliche Perspektive: In diesem Artikel werden die negativen Auswirkungen des Gender Data Gap auf die Gesellschaft und das Verwaltungswissenschaft beleuchtet, und aufgezeigt wie der Gap langfristig überwunden werden kann.

    „As data increasingly inform every aspect of our lives, gender discrimination in the collection and application of female-based data has also risen. Because data are primarily sourced from (white) men, the solutions we design to address global problems are also primarily based on men, i.e. male bodies, male preferences and prototypical male life choices. The Gender Data Gap – referring to the circumstance that most data on which organisational decisions are based appear to be biased in favour of (white) men – describes this very absence of information about aspects of women’s lives. In this article, we not only demonstrate how the Gender Data Gap (negatively)impacts society and management science, but also highlight how the gap can be overcome in the long run. Further, we showcase several initiatives, particularly European ones, that suggest opportunities to gradually close the Gender Data Gap.“

    https://www.sciencedirect.com/science/article/pii/S0263237322001554

    NHTSA Report: „Newer Cars Appear to Significantly Reduce Gender Disparities in Crash Outcomes“ (08 2022)
    Zitat: „“Advancing equity, including across our transportation system, is one of the Biden-Harris Administration’s top priorities,” said Dr. Steven Cliff, NHTSA’s Administrator. “While NHTSA’s new report shows significant declines in differences in crash outcomes between women and men, there is more work required to eliminate any disparities that remain.” 
    https://www.nhtsa.gov/press-releases/nhtsa-report-newer-cars-appear-significantly-reduce-gender-disparities-crash

    Corina Klug, Johan Iraeus, Astrid Linder et al:
    Oktober 2023 erschien in einer Serie von Untersuchungen eine Studie zum Thema „Wie stark unterscheidet sich das Verletzungsrisiko zwischen einer durchschnittlichen weiblichen und einer durchschnittlichen männlichen Anthropometrie? Eine Simulationsstudie mit Open-Source-Tools für virtuelle Crash-Sicherheitsbewertungen“ übersetzt mit DeepL.
    „Differences in injury risk between females and males are often reported in field data analysis. The aim of this study was to investigate the differences in kinematics and injury risks between average female and male anthropometry in two exemplary use cases.„
    https://www.researchgate.net/publication/374665940_How_much_does_the_injury_risk_between_average_female_and_average_male_anthropometry_differ_-A_simulation_study_with_open_source_tools_for_virtual_crash_safety_assessments

    E.V.A. Initiative – Equal Vehicles for All „This initiative is to ensure everyone is represented – not just men, but women and children – when designing for safety.
    „We believe everyone has a right to be safe. Since 2019, through the E.V.A initiative, we’ve shared over 40 years of safety research. It’s open for anyone to download.
    Unter dem folgenden Link gibt es diese Daten und Reports
    https://developer.volvocars.com/resources/eva/reports/#1970-1980

    Deutschlandfunk: Wer mehr über den ersten „echten“ weiblichen Crash Test Dummy wissen möchte, kann hier sehen und hören:

    https://www.deutschlandfunknova.de/beitrag/crashtest-dummies-der-erste-echte-weibliche-dummy-kommt-aus-schweden

    Auch „Die Zeit“ berichtete darüber. Im Artikel aus dem Jahr 2022 werden gibt es auch Zweifel an den Chancen von EVA geäussert. Von einem Unfallforscher. Ein gute Möglichkeit, selber mal Quellen kritisch zu betrachten.
    https://www.zeit.de/mobilitaet/2022-11/gender-data-gap-autos-crashtest-dummys-frauen

    Die Bildquelle 

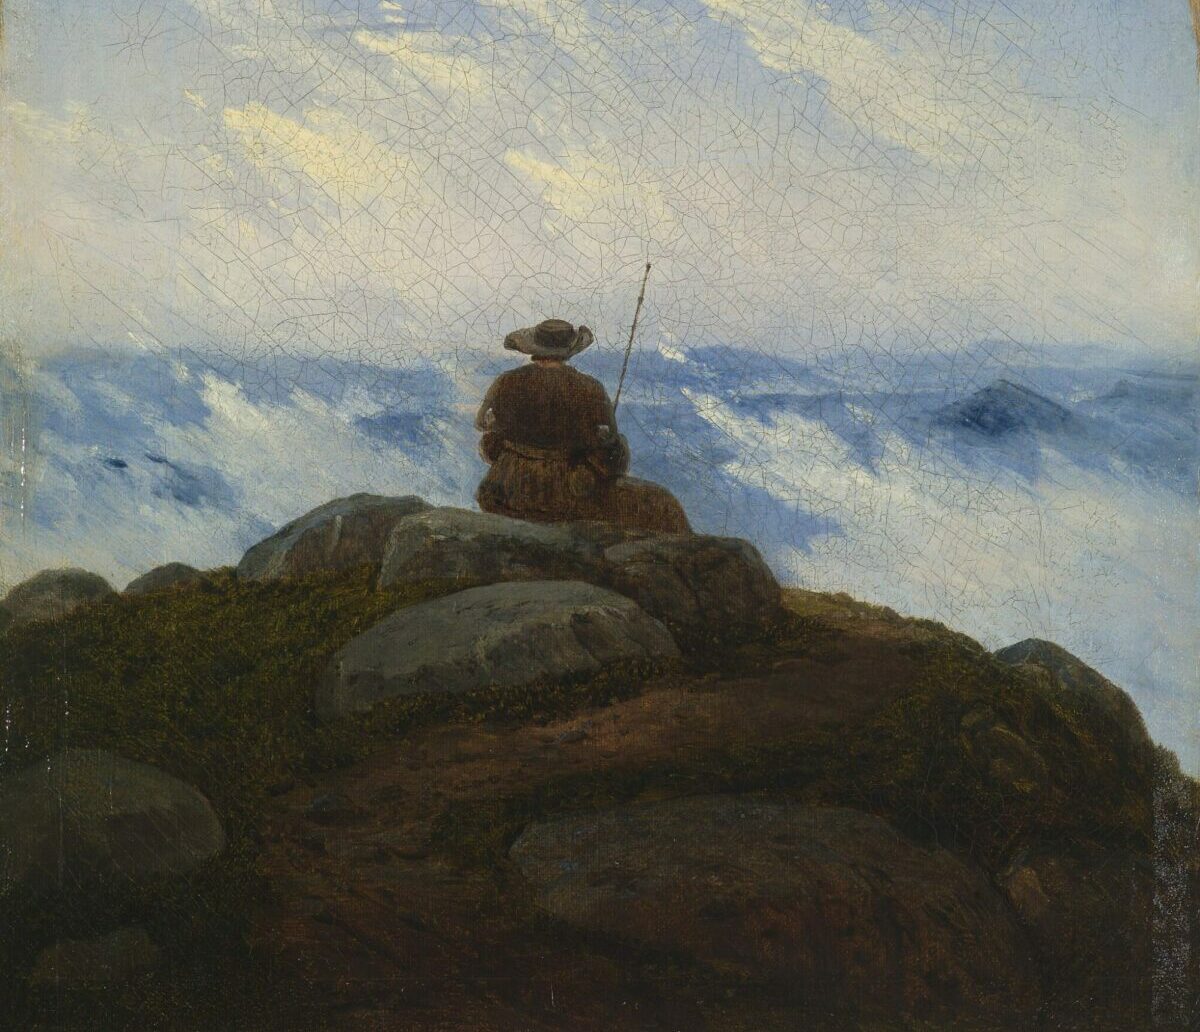
    Das Bild zeigt „Die Ruhe des Pilgers / Wanderer auf Bergeshöh„, einen Mann der in ein von Nebel verhülltes Tal schaut. Er kann nur ahnen, was sich dort unten befindet, sein Pilgerstab eignet sich nicht zum Stochern im Nebel oder Fischen im Trüben. Selbst eine KI könnte ihm wahrscheinlich nicht helfen. Es fehlen Daten.

    Das Bild stammt von ⁠Carl Gustav Carus⁠ (1789–1869) und wurde 1818 in Öl gemalt. 
    ⁠https://upload.wikimedia.org/wikipedia/commons/1/1a/Carl_Gustav_Carus_-_Wanderer_on_the_Mountaintop.jpg

  • Deepfakes – Erinnerungen werden lebendig.

    Deepfakes – Erinnerungen werden lebendig.

    S2/E31 Homer ließ Odysseus in seinen Erzählungen lebendig werden. Aber die Möglichkeiten, sich an Menschen und Ereignisse zu erinnern sind längst digitalisiert. Dabei meinen wir nicht nur digitale Bilder, die in ihrer Vielzahl „geschossen“ in unseren Speichern im Rechner oder der Cloud im Wortsinne festgehalten wurden.

    Wenn wir uns erinnern wollen an Ereignisse von Familie, Städten, Vereinen, Technologien können uns Fotoalben weiterhelfen. Auch auf öffentlichen Speicherplattformen wie Vimeo oder YouTube „leben wir bewegt“ und lassen von uns hören in Podcasts – wie dem von achwas?!

    Kein Spotify-Link? Bitte Seite erneut laden.

    So war es nur eine Frage der Möglichkeiten, der Fantasie und Handwerkskunst diese Fülle von Bildern, Texten und Sprache zusammen zu führen. Daraus ein lebendig erscheinendes Abbild von Menschen zu erstellen.

    Das „zum Leben erwecken“ lässt sich bei digitalisierten Medien relativ einfach gestalten. In immer schnellerer Folge begegnen wir in den Medien Wesen, deren Stimme, Gesicht und Mimik uns vertraut erscheinen, wo der Inhalt allerdings abweicht von dem, was wir kennen und erwarten.

    Ein aktuelles Beispiel wurde vom „Zentrum für politische Schönheit“ erstellt. Da verkündet Bundeskanzler Olaf Scholz Ende 2023 das Verbot der AfD. Wie sich schnell herausstellte, war das ein Deepfake.

    Was denn nun Deepfakes genau sind, und woher der Begriff kommt? Spoiler: aus den Begriffen „Deep Learning“ (mehrschichtiges Lernen) und „fake“ (Fälschung) gebildet bezeichnet dies mittels Künstlicher Intelligenz erstellte Bilder und Videos. Deep Learning ist eine Methode, die aus – für den Rechner vom ersten Schritt – „verwirrenden“ Pixeln z.B. eines Bildes – in vielen nachgelagerten Schichten von Mustererkennung etwas dekodiert, was sich in den eingelesenen Daten (Bsp. Bilder von Hunden) als ein maschinenlesbares „Urbild Hund“ immer wieder bestätigt. Diese Bilder können parametrisiert werden, d.h. durch Befehle oder auch Regler in Farbe oder Form oder Bewegungen verändert werden. So wird aus einer Mücke ein Elefant, der fliegen kann und dabei Löwengebrüll ausstößt. Meistens sind es allerdings „Promis“, die uns scheinbar verwirren.

    In unseren Quellen finden sich einige Beispiele für Deepfakes. Wir weisen in dieser Folge einen weiteren Aspekt von Deepfake hin – die Möglichkeit, Angehörige und Freunde oder auch Personen und Zeugen der Zeitgeschichte, ja, fast zum Leben zu erwecken. Oder zumindest über sich und Ereignisse Auskunft zu geben. Dies wurde möglich gemacht für Menschen, die der Shoah (Holocaust) entkamen und Zeugnis geben über Schrecken und Unmenschlichkeit einer unermeßlicher Dimension.
    Aber diese Technologie kann für jegliche Erinnerung verwendet werden. Am Beispiel von vier Unternehmungen machen wir deutlich, wie dies die Trauerarbeit unterstützen, aber vielleicht auch ver- und zerstören kann.

    Quellen

    Upload (Amazon Streaming Serie zur Zeit in drei Staffeln)
    „Upload spielt im Jahr 2033. Menschen können sich in in eine virtuelle Welt hochladen lassen. Der Kontakt zur „echten“ Welt findet über Telefonate, SMS, Videokonferenzen oder auch holographische Repräsentanzen statt. Auch in der virtuellen Welt begegnen die Hochgeladenen Bannern und Cookies und einem gewissen Zwang mit Sternen Leistung zu bewerten. Da der Aufenthalt von Lebenden finanziert wird, ist das verfügbare Datenvolumen die Währung für ein angenehmes Leben nach dem Tod.

    Beitrag der BBC: Forscher der Universität von Washington haben den ehemaligen US-Präsidenten Barack Obama fotorealistisch als Deepfake nachgebildet.
    Mithilfe künstlicher Intelligenz wurde genau modelliert, wie Herr Obama seinen Mund bewegt, wenn er spricht.
    Ihre Technik ermöglicht es ihnen, ihrem synthetischen Barack Obama beliebige Worte in den Mund zu legen. (Übersetzt mit DeepL aus der folgenden Quelle:)
    https://www.youtube.com/watch?v=AmUC4m6w1wo

    Eine Keynote zu KI auf Amazon re:MARS 2022 von Rohit Prasad, SVP and Head Scientist, Alexa AI, Amazon

    /https://www.youtube.com/watch?v=22cb24-sGhg&t=3733s

    Seine Keynote beginnt hier 43:36 (zum Schluß die gute Nacht Geschichte, von Alexa mit der Stimme der Großmutter erzählt.

    Mehr zu Deepfake und mehr Videos auf „Deutsche Welle“. Sehr gut eine Zusammenstellung, wie man Deepfakes erkennen kann
    https://www.dw.com/de/faktencheck-wie-erkenne-ich-deepfakes/a-60192155

    Das „Zentrum für Politische Schönheit (ZPS)„, Website
    https://politicalbeauty.de

    Die Beispiele aus dem Podcast


    Storyfile: Tell me, Inge! Reden Sie mit der Holocaust Überlebenden Inge Auerbacher. Etwas scrollen, bis zu den Demos ist die App mit Inge die erste in einer Reihe von Beispielen. Clicken, Lautsprecher einschalten und mit Inge sprechen.
    https://storyfile.com

    Mehr dazu vom „Macher“ des „Deepfakes“

    https://www.elmhurst.edu/news/usc-shoah-foundations-stephen-smith-to-give-holocaust-lecture-on-april-24/

    Project December: Simulate the Dead.

    Project December is the first system in the world of its kind. Using patent-pending technology, in conjunction with deep AI running on one of the world’s most sophisticated super-computers, we can now simulate a text-based conversation with anyone. Anyone. Including someone who is no longer living.
    Selbstaussage von Project December

    https://projectdecember.net

    WDR 5, Neugier genügt: Das kalifornische Startup „HereAfter AI“ hat eine App entwickelt, die mithilfe von KI „Gespräche“ mit unseren Liebsten ermöglicht – auch nach deren Tod. Nils Dampz hat das Startup besucht, dessen Mitgründer getroffen und die App ausprobiert. Hilft ein KI-Sprachbot bei der Trauer?
    https://www1.wdr.de/mediathek/audio/wdr5/wdr5-neugier-genuegt-freiflaeche/audio-sprechen-mit-verstorbenen–dank-kuenstlicher-intelligenz-100.html

    Die Hereafter App
    „Preserve memories with an app that interviews you about your life. Then, let loved ones hear meaningful stories by chatting with the virtual you.“
    https://www.hereafter.ai

    Trigger Warnung.
    Auf den Videokanälen der Munhwa Broadcasting Corporation (MBC), einem der drei größten Rundfunksender Süd-Koreas, findet man die Mutter/Tochter Geschichte, die mittels VR Brille und Deepfakes ein (einseitiges) Wiedersehen der Mutter mit der verstorbenen Tochter ermöglicht. Das Video endet mit dem symbolischen Tod der Tochter, die sich von der Mutter verabschiedet und als Schmetterling davon fliegt.
    https://www.youtube.com/watch?v=uflTK8c4w0c&t=35s

    Dieses Video wird in einem umfassenderen Bericht zum Thema am 6.11.2022 auf der schweizerischen Website watson erwähnt.
    https://www.watson.ch/wissen/digital/446276751-wenn-tote-reden-start-ups-schaffen-digitale-versionen-von-verstorbenen

    Der juristische Teil (Bald ehr dazu auf diesem Kanal achwasfm.janlucash.com/).

    AI-Act der EU
    Zusammenfassung (deutsch)
    https://www.europarl.europa.eu/news/de/headlines/society/20230601STO93804/ki-gesetz-erste-regulierung-der-kunstlichen-intelligenz

    Zusammenfassung (englisch)
    https://www.europarl.europa.eu/news/en/press-room/20231206IPR15699/artificial-intelligence-act-deal-on-comprehensive-rules-for-trustworthy-ai

    Die Suchseite zum Thema (EU Parlament)
    https://www.europarl.europa.eu/news/de/search?searchQuery=AI+Act+document

    Datenschutzgrundverordnung (DSVGO)
    Hier die Übersicht zur DSGVO (Europaparlament). Hier findet sich nicht nur „das Gesetz“ und die Erläuterungen, sondern auch Artikel, Gerichtsurteile und mehr. Auch FaceBook / Meta / Zuckerberg taucht auf.

    https://www.europarl.europa.eu/news/de/search?searchQuery=DSGVO

    Folgen-Bildquelle

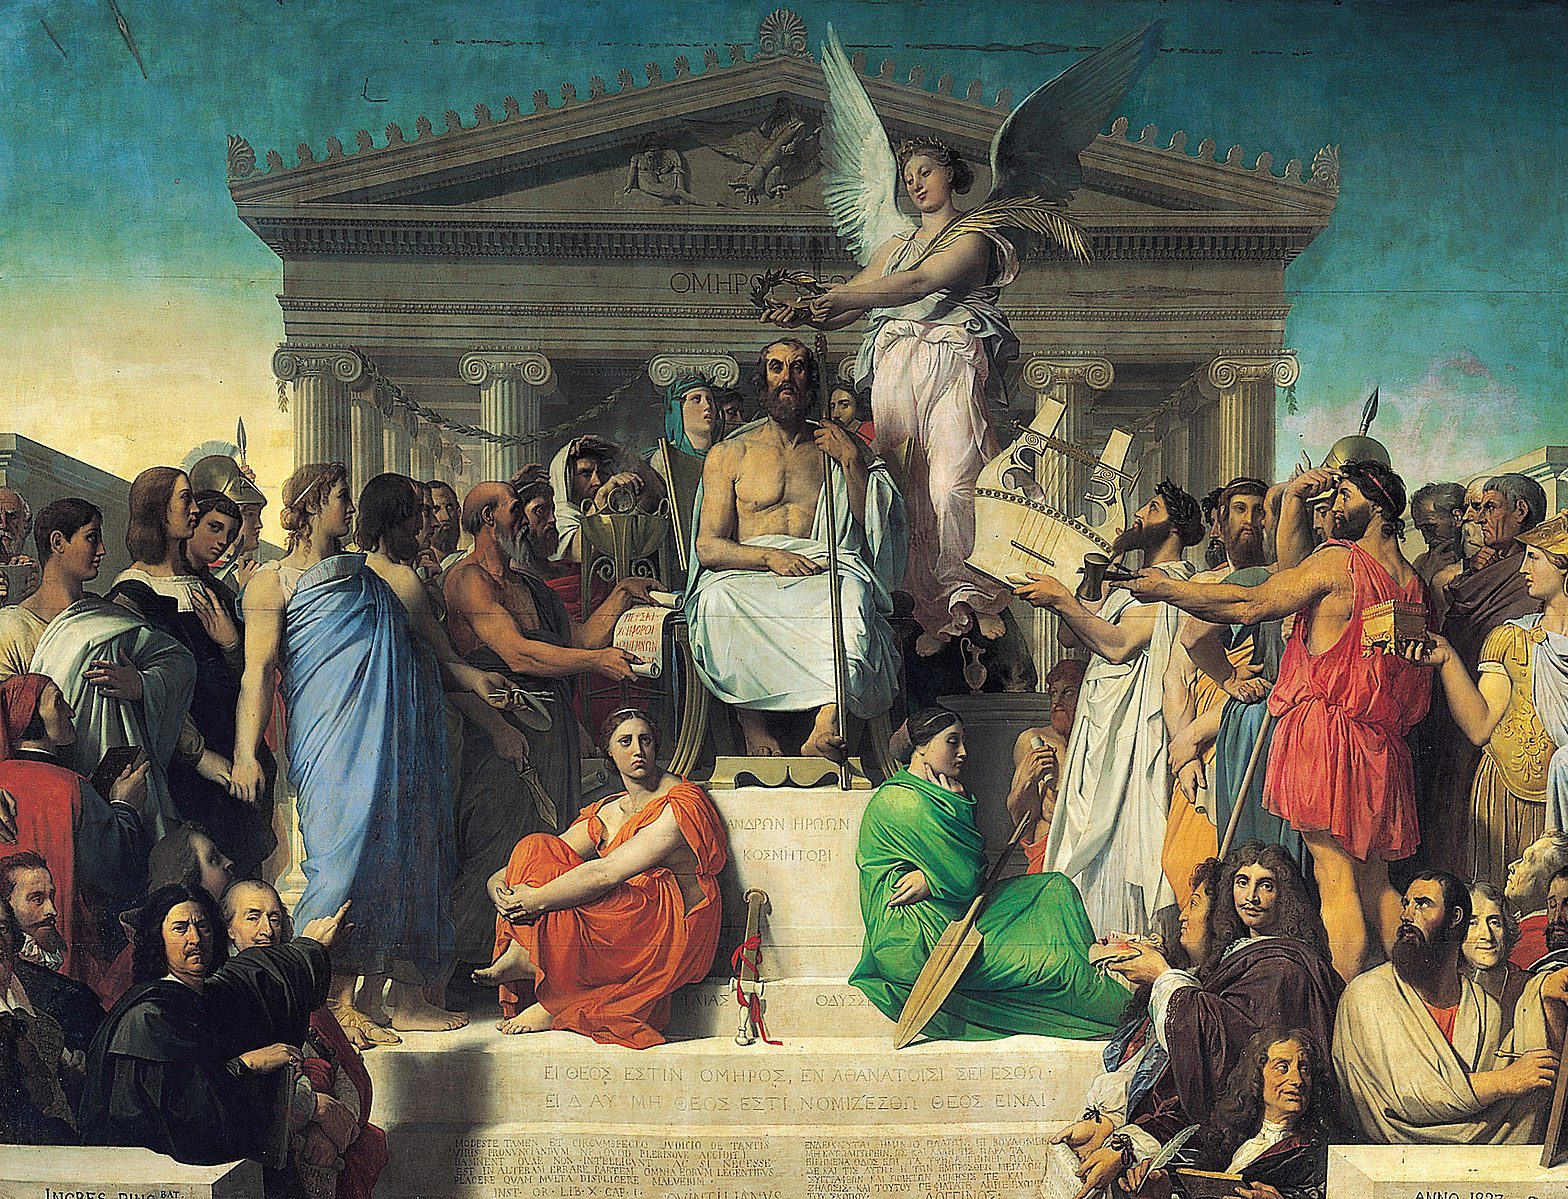
    Zugleich ein Familienbild, und eine Fakenachricht und ein Fake in der Darstellung von Menschen der Geschichte oder vielleicht Fiktion? Lassen Sie sich nicht verwirren:
    Es zeigt ein Gemälde von Jean Auguste Dominique Ingres. Benannt ist es als die „Apotheosis Homers“ und stammt aus dem Jahr 1827. Als Apotheose wird die Gottwerdung eines Menschen bezeichnet.
    Wir empfehlen, das Bild auf der Wikimedia aufzusuchen. Zum einen gibt es mehr Infos und: alle abgebildeten Wesen werden identifiziert und man erfährt ihre Namen. Wenn Sie Zeit haben und Lust dazu – vielleicht probieren Sie so viele wie möglich selbst zu erkennen.

    https://commons.wikimedia.org/wiki/File:Jean_Auguste_Dominique_Ingres,_Apotheosis_of_Homer,_1827.jpg

  • Wird`s noch was? Die Zukunft des Webs.

    Wird`s noch was? Die Zukunft des Webs.

    S2E29 Ist unser Web wirklich kaputt? Gekapert von Wegelageren, Hütchenspielern und Trickbetrügern? Oder geht noch was?

    Wäre doch eigentlich eine feine Sache, das Web ohne Tretfallen. Aber von welchem Web sprechen wir eigentlich? Und welchen Standpunkt haben wir inzwischen eingenommen, durch eigene Erfahrung oder Hörensagen (den Gerüchten aus unseren Echokammern)?
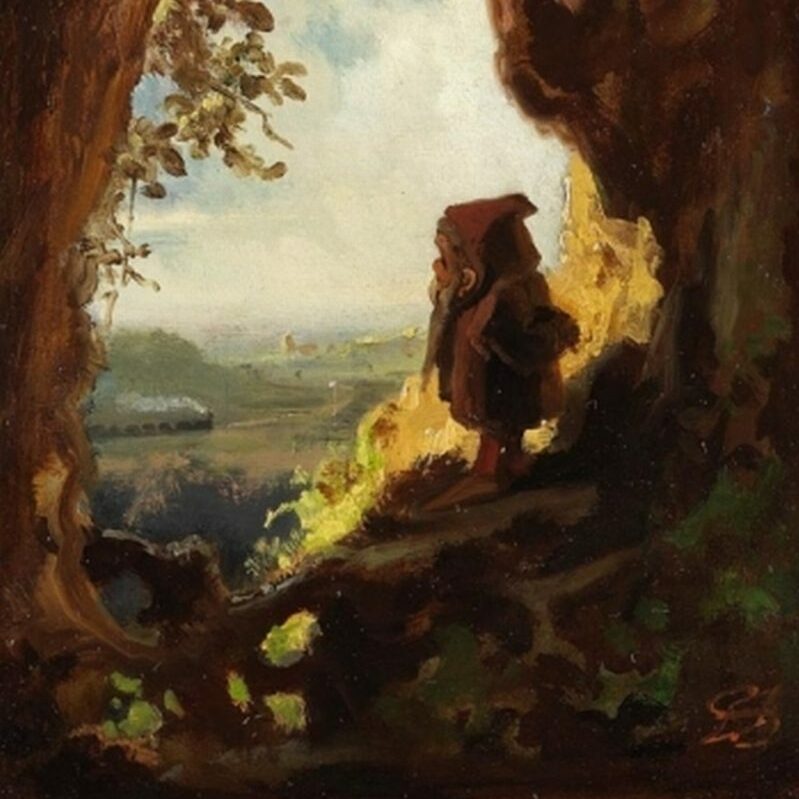
    Vielleicht betrachten wir das Internet wie aus der Perspektive des Gnoms von Spitzweg, der aus seiner Höhle in der Höhe die schnaufende Eisenbahn im Tal als ein vorüber dampfendes Ereignis bewertet.

    Eins nach dem anderen, welche der Webs schauen wir uns in dieser Folge an? Alle:

    • Das Urweb (1.0), wurde gemacht um statisch Informationen und Daten abzulegen, wieder zu finden, zu lesen und abzurufen (so war es tatsächlich 1989 gedacht). Mit einer traditionellen Struktur: Die Seiten werden technisch vom / von „Webmaster“ erstellt und gepflegt. Content erstellen Autor:innen.
    • Das Web 2.0, das Mitmachweb, die „Social Media Himmel-Hölle“ mit neuen Möglichkeiten Geschäfte zu betreiben seit 2003/04. Hier können „normale“ User Geschichten erzählen, Produkte und das Leben (der Anderen) kommentieren. Sowohl der Bau von Webseiten wie auch Content liegen in unserer Hand. Das bedeutet Verantwortung, Könnerschaft, Demut. Nunja.
    Hier kann die Folge auch gehört werden. Geht nicht? Manchmal hilft ein "Reload" (Seite nochmal aufrufen) bei scheuem Content...

    Wir suchen Rat beim Erfinder der Version 1.0: Sir Tim Berners-Lee. Angefressen von all‘ den Rüpeleien, die die Unzulänglichkeiten seiner Version 1 und der 2 ermöglichen, entwickelte er (mit Kolleg:innen) die 3.0 Version und das „Solid Protokoll“ aus dem bestehenden Web Protokollen.

    Was bei 3.0 denn nun anderes hat, klären wir auf.
    Quellen, Texte, Verweise auf Erklärvideos Tipps. und der Link, um 3.0 zu erleben folgen.

    Wir glauben – das wird was Gutes. Wenn wir mitmachen. 

    Die Quellen


    Hinweis vorab:
    Das Krypto / Blockchain Web namens Web3 ist nicht 3.0. Hier findet man einen guten Einstieg ins Thema – die Links im Wikipedia Artikel führen weiter:

    https://de.wikipedia.org/wiki/Web3

    Eine von vielen Aufrufen, etwas für das Web zu tun, ist der Copenhagen Letter von 2017.
    Gute Analyse, gute Beschreibung des Status Quo. Der Text findet sich auf vielen Websites, die originale Website gibt es nicht mehr.
    Hier ist Letter bei „wired“ zu finden (Achtung, Cookie Consent Falle mit Cookie Ablehnung umgehen):
    https://www.wired.com/beyond-the-beyond/2017/09/the-copenhagen-letter/

    https://www.ted.com/talks/naomi_klein_addicted_to_risk?subtitle=en


    Eine subjektive Auswahl an achwasfm.janlucash.com/ Episoden, die weiterführende Infos geben:

    • S2/E25 Microsoft greift an: MS Engagement in der Werbeindustrie und bei OpenAI – Was sind die Hintergründe?
    • S2/E23 Cookies: Mostly Harmless? Cookies sind nicht nur kleine Dateien, die als „Keycard“ fürs Login dienen. Sie können freche „Spionagetools“, die im Gegenteil die Tür in unsere Browser und unser Leben für Werbetreibende öffnen!
    • S2/E22 I hope, you are not concerned. Chat GPT könnte die Grenzen zum menschlichen Denken bereits durchbrochen haben. Ist das System emergent, also entwickelt Eigenschaften, die man nicht vorhersehen kann?
    • S2/E15 Die unbekannte Geschichte des Silicon Valley. Waren die Entwicklungen im Silicon Valley seit 1939 nur Kinder des Zufalls? Ein Glücksfall jedenfalls für eine schöne Gegend, die auch einen guten Ruf als Apfelplantage hatte.
    • S2/E14 Nichts Gutes, außer man tut es. Die Handlungstheorie stellt den Rahmen für gutes Webdesign in jeglicher Hinsicht bereit. Denn sie bringt Wünsche, Ziele, Emotionen in Einklang. Und eignet sich auch dazu die Ablenkung vom Ziel bewusst zu inszenieren um Tand und Klatsch hinterherzulaufen
    • S2/E12 Echte Mogelpackungen – Parasoziale Beziehungen und Authentizität. Wollen Medien überzeugen, brauchen sie authentische Menschen, die eine soziale Beziehung zu Menschen aufbauen und halten können. Manchmal reichen auch „parasoziale Beziehungen“, um wohlige Gefühle auszulösen. Ein Beispiel sind TV Moderatoren im Jahr 1956, die so tun als ob sie zu Gast im Wohnzimmer der Zuschauenden wären. Auch Influencer schaffen das heutzutage, wobei diese altbewährte Techniken nutzen.
    • S2/E10 Alles top, immer wieder gerne! Über Opinion Spam. Fünf ***** Sterne überzeugen, das muss ja gut sein. Sie zweifeln? In dieser Episode bekommen Sie allen Grund dafür.
    • S2/E07 Du ahnst es nicht! Datamining rockt. Und die Daten von ihnen und über Sie sind niemals harmlos, oft sogar sehr nützlich. Zumindest in den Händen kundiger Interessenten. Wenn Sie wüssten was man so alles über Sie rausfinden kann? Wollen Sie wissen? Dann ist das „ihre Episode“.
    • S1/E41 Was nützt Aufklärung? Edward Snowden und die Folgen.
      Er ist immer noch Staatsfeind, seit 2013. Manche wünschen ihn nicht nur hinter Gittern, sonder „6feet under“. Was hat Snowden getan? Er hat aufgedeckt, dass mit der Hilfe von High Tech Staaten ihren Bewohnern hinterher spionieren. Und in einem unglaublichen Ausmaß die Privatheit durchdringen, dass selbst FaceBook / Meta wie ein neugieriges 3jähriges Kind am Schaufenster der Eisdiele erscheint.
    • S1/E19 Die FaceBook Papers – Spielregeln des Kapitalismus. Frances Haugen, eine hochrangige Mitarbeiterin von Meta ist wahrscheinlich eine der wichtigsten Whistleblower der jüngeren Geschichte. Die Episode ist aktueller denn je. Denn in 41 /50 Staaten der USA ist Meta zur Zeit (Mitte 11/2023) angeklagt: Sie wussten sehr viel über die krankmachende und verstörende Wirkung ihrer Produkte bei den Nutzern. Meta wog sorgfältig ab und legte Verantwortung in die eine und den daraus zu erzielenden Profit in die andere in die andere Waagschale. Nun denn, Geld wächst nicht auf Bäumen und Meta ist ein SocialMedia Konzern, nicht ein Sozialverein auf Gegenseitigkeit. Unsere Einsichten zum Thema waren verstörend.

    Deutschlandfunk Hörsaal vom 02. November 2023
    Wenn Informationstechnik breitflächig ausfällt, dann geht nichts mehr: Banken, Supermärkte oder Krankenhäuser sind darauf angewiesen. Wie anfällig ist unsere digitale Infrastruktur?
    Ein Vortrag des Informatikers Jochen Schiller.

    „Niemand weiß, wie das Internet eigentlich aussieht“, sagt der Informatiker Jochen Schiller. „Aber wir hängen alle von ihm ab“. 
    https://www.deutschlandfunknova.de/beitrag/kuenstliche-intelligenz-unsere-digitale-infrastruktur-ist-angreifbar

    Quellen zu Tim Berners-Lee
    Ausgangspunkt für das Web 3.0 waren die Konzepte von T B-L zum Thema LinkedData / Semantisches Web 2006/2009
    https://www.w3.org/DesignIssues/LinkedData.html

    Deutschlandfunk Kultur, Beitrag vom 6.10. 2018
    Wie WWW-Erfinder Tim Berners-Lee das Internet retten will: „Die Neuerfindung des Web“.

    „…Die Macht im Web wieder verschieben können, weg vom Betreiber des Servers, zurück zum Nutzer. Denn heute liegen unsere Daten auf den Servern von Facebook, Google und Amazon.

    Berners-Lee will, dass die Daten bei uns, unter unserer Kontrolle sind. Und so hat er mit anderen vor allem im letzten Jahre „Solid“ entwickelt, eine Open-Source-Software, mit der das Web ganz neu organisiert werden kann. Kern-Element sind persönliche Daten-Lager, sogenannte PODs, die sich jeder schon jetzt gratis anlegen kann.“
    https://www.deutschlandfunkkultur.de/datenhoheit-den-nutzern-zurueckgeben-wie-www-erfinder-tim-100.html

    Artikel in FORBES über Web3 (Blockchain / Krypto Währungen) und Web 3.0 (27.4.2023)

    https://www.forbes.com/sites/digital-assets/2023/04/27/substack-and-inrupt-not-waiting-for-web3-to-enforce-user-rights/?sh=58791504b49d

    SOLID & PODs
    Im Git-Hub gibt es umfangreiche Infos

    https://github.com/solid/solid

    Weiteres hier
    https://solidproject.org

    Kommen wir zur Website der Fa. INRUPT (Mitgründer Sir Timothy Berners-Lee)
    SOLID & PODs in der Presse
    https://www.inrupt.com/coverage

    Die SOLID Produkte
    https://www.inrupt.com/products/enterprise-solid-server

    Die Erklärvideos sehr empfehlenswert
    https://www.inrupt.com/videos

    Testaccount anlegen
    https://start.inrupt.com/profile

    Einloggen
    https://login.inrupt.com/openid

    Bitte am Ball bleiben …die Experience am 21.11.23 ist eher experimentell

    Das Folgenbild

    Das Folgenbild wurde 1848 von Carl Spitzweg auf dem Deckel einer Zigarrenschachtel gemalt und trägt den Titel „Gnom, Eisenbahn betrachtend“. 

    Dieser Gnom ahnt, dass die neue Technik Neues bringt, bleibt aber hoffnungsvoll skeptisch dass es tatsächlich passieren wird. Bleibt er in seiner Höhle, wird er es immer nur aus 2. Hand erfahren.

    Quelle Folgenbild:

    https://commons.wikimedia.org/wiki/File:CarlSpitzwegGnomEisenbahnbetrachtend.jpg

  • Cookies: Mostly harmless?

    Cookies: Mostly harmless?

    S2/E23 Schon Hänsel und Gretel hatten ihre Probleme mit Keksen oder Brotstücken. Sie sollten ihnen den Weg aus dem Wald weisen, die Krümel wurden allerdings vor dem Einsatz als Wegweiser von den Vögeln aufgepickt. Vielleicht war dieses Märchen, gesammelt von den Gebrüdern Grimm, die Blaupause für ein stetiges Ärgernis im Web: Cookies. Harmlos? Spionagetools? Komfortabel?


    Und gibt es was Neues zu Cookies?
    Diese „Cookie“ Geschichte hinter den Pixeln führt uns vielleicht in ein Tollhaus, zeigt uns aber auf jeden Fall deutlich den stetigen Kampf im Web zwischen unserer Bequemlichkeit und der notwendigen Aufmerksamkeit, um nicht als Teil eines gut gefütterten, profitablen Datensatzes bei einem Databroker in den USA zu landen.

    Dabei fing alles so harmlos an, will man uns weissmachen. Kleine Textdateien würden Informationen enthalten die dazu dienten, uns das Einloggen auf unseren liebsten Seiten zu erleichtern. Was auch spürbar richtig war. Weshalb diese „Cookies“ genannt wurden? So genau weiss man es nicht, der Erfinder Lou Montulli erzählt die Geschichte von HTTP Dateien, die beim Laden einer Webseite zur Wiedererkennung genutzt werden und „Magic Cookie“ genannt wurden.

    Aus den Cookies wurden über die Zeit Schokoriegel, die in ihrem Inneren mit Schokolade, Creme, Nüssen und Angelhaken bestückt werden könnten. Und ihren wahren Charakter unter falscher Flagge zuckersüß verstecken konnnten.

    Aber das schon mal vorweg: Harmlose Textdateien waren es so wirklich nie. Cookies scheinen uns Menschen alledings „schmackhafter“ als wenn wir einen „Datenbankeintrag“ aufgetischt bekämen.

    Quellen

    AFFILIATE-MARKETING GRUNDLAGEN, METHODEN UND EXPERTENWISSEN
    Zitat: „Du möchtest Dir ein Affiliate-Business aufbauen oder Dein Geschäftsmodell optimieren? Jan Schusts Standardwerk bietet Dir einen Überblick über wichtige Themen der Branche. Lies exklusiv bei uns einige Auszüge:“
    https://www.100partnerprogramme.de/affiliate-marketing/

    Zitate aus dem sehr informativen Blog dr-dsvgo.de
    „Einwilligungsabfragen werden oft als Cookie Popups oder Cookie Tools bezeichnet und als solche angesehen, obwohl dies falsch ist. Noch schlimmer sind Webseiten, die sogenannten Cookie Blocker einsetzen, die alle einwilligungspflichtigen Plugins nachträglich deaktivieren sollen, bis eine Einwilligung vom Nutzer erteilt wurde. Moderne Browser und Ad Blocker blockieren diese Cookie Dienste, die dann wiederum die kritischen Plugins nicht mehr blockieren können.“
    https://dr-dsgvo.de/das-ende-der-cookie-blocker-datenschutzfreundliche-browser-und-werbeblocker/?z=393811832&msh=11466&ct=0

    Consent Tools aus Sicht der Affiliates mit dem wichtigen Hinweis: Über „Tricks“ gewonnene Einwilligungen können rechtswidrig sein.
    „Dark Patterns im Consent Management – und warum Sie lieber darauf verzichten sollten
    „Dark Patterns sind bei der Gestaltung von Cookie-Bannern weit verbreitet. Warum die Nutzer Einwilligung dann allerdings nicht gültig ist, erklären wir hier“.
    https://usercentrics.com/de/knowledge-hub/dark-patterns-im-consent-management/

    Einsatz von Third Party Cookies
    Zitat: „Cookies von Drittanbietern werden aussterben – da ist sich die Branche mittlerweile einig. Kein Wunder, basieren sie doch auf einer vergleichsweise veralteten Technologie, die nicht zuletzt immer wieder aufgrund ihrer invasiven Wirkung in Frage gestellt wird…“
    https://usercentrics.com/de/knowledge-hub/google-ersetzt-floc-durch-topics/


    Eine recht vollständige Übersicht zu Affiliate Programmen: Themen, Unternehmen, Provisionen

    https://www.100partnerprogramme.de/themen/

    Data Brokerage – Zahlen und Fakten zu einem interessanten Business
    Der Markt für Zahlen, Daten, Fakten des Marktes Data Brokerage ist vielfältig. Die Prognosen weichen zum Teil stark voneinander ab. Die folgende Quelle berücksichtigt die Einschränkungen des Datenmarktes mit Consumer Data (Private Daten) und die Ausweitung des Marktes von IoT (Internet of Things: Smart Home, Sensoren, CCTV, Verkehrsdaten, Out Of Home Media (Aussenwerbung) etc.
    Die im Podcast genannten Umsätze nutzen diese Quelle:
    „The global data broker market was valued at US$319.030 billion in 2021 and is expected to grow at a CAGR of 7.96% over the forecast period to reach US$545.431 billion in 2028.“
    https://www.knowledge-sourcing.com/report/global-data-broker-market

    Episodenbild

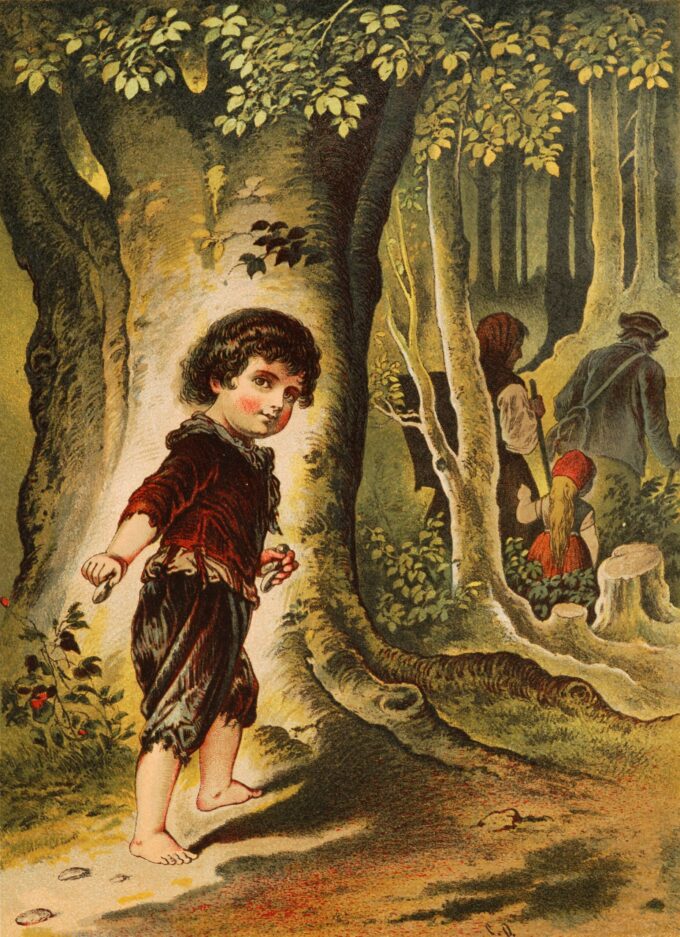
    Kaum ein Märchen hat Begrifflichkeiten und Methoden im Web so stark geprägt wie die Geschichte von Hänsel und Gretel*. Bekannt sind die „Breadcrumbs“ in der Navigation auf einer Webseite. Die Krümel helfen uns bei der Orientierung und zeigen, wie wir „hierhin“ gekommen sind.

    Wer das Märchen kennt weiß, dass Kieselsteine als permanente Markierungen besser geeignet sind zur „Navigation“.

    Das Episodenbild zeigt uns Hänsel, in den Händen jeweils einen hellen Kieselstein. Voller Zuversicht schaut er uns an, diesmal klappt es, den Weg zurück zu finden. Im Hintergrund sieht man Vater, Mutter und Gretel.

    Das Bild wurde Ende des 19.Jhds für einen Märchenband von Carl Offterdinger gezeichnet.

    Aus: „Mein erstes Märchenbuch“, Verlag Wilh. Effenberger, Stuttgart, Ende 19. Jhd.

    ⁠https://commons.wikimedia.org/wiki/File:Offterdinger_Hansel_und_Gretel_(1).jpg?uselang=de#/media/File:Offterdinger_Hansel_und_Gretel_(1).jpg⁠

    *Anmerkung 1: Zugegeben – ich kenne nur „Hänsel und Gretel“ als Märchen, dem ich einen Einfluß auf Bezeichnungen von Web und Navigationsanwendungen in Land-, See- und Luftfahrzeugen unterstellen könnte.

    **Anmerkung 2: In der ersten Fassung der Beschreibung habe ich zuerst die Brotkrümel, und dann die Kieselsteine als Navi-Hilfen erwähnt. Richtig ist: Der erste Versuch die Kinder auszusetzen misslang, weil Hänsel Kieselsteine mitführte. Der zweite Versuch wäre fast geglückt. Hänsel hatte nur Brotkrumen mit zur Kennzeichnung des Weges. Sie wären verhungert, wenn sie nicht auf ein Lebkuchenhaus (essbar) gestoßen wären. Insgesamt eine Geschichte voller Gewalt, seitens der Eltern, der Hexe und auch der Kinder.

  • Die Cyber-Autodiebe. Achwas?!Crime

    Die Cyber-Autodiebe. Achwas?!Crime

    (S2/E17) Fahren Sie ein Auto? Parken Sie am Straßenrand? Hat sich schon mal jemand an Ihrem Auto zu schaffen gemacht, in der Nacht? Wir erzählen heute nicht nur die Geschichte von einem ungewöhnlichen Autodiebstahl in London vor knapp einem Jahr. Wir zeigen auch auf, wie sehr die Techniken der Attacken im Webs genutzt wurden, diesen Diebstahl erst möglich zu machen.

    Die Hauptperson unserer Folge ist ein Cybersecurity Experte – für Automobile. Zur Klärung: Wir reden nicht vom 25. Jhd, sondern vom Jahr 2022. Auch ist dieser Experte, Ian Tabor (wohnhaft in London) kein fiktiver Zeitreisender. Bevor es noch verwirrender wird, lassen wir doch seinen Freund Dr. Ken Tindell, zu Wort kommen. Beide beschäftigen sich mit elektronischen Systemen in Fahrzeugen.

    Dr. Ken Tindell schreibt in seinem Blog:

    „Dies ist eine Detektivgeschichte darüber, wie ein Auto gestohlen wurde – und wie dadurch eine regelrechte Epidemie von Hightech-Autodiebstählen aufgedeckt wurde. Sie beginnt mit einem Tweet. Im April 2022 twitterte mein Freund Ian Tabor, dass sich Vandalen an seinem Auto zu schaffen machten, den Scheinwerfer ausbauten und die Kabel abzogen“
    Und etwas später: „Das Auto war weg. Und es sieht so aus, als ob der Scheinwerfer die Diebstahlmethode war.„

    Quelle: https://kentindell.github.io/2023/04/03/can-injection/ übersetzt ins Deutsche von DeepL.

    Auch in dieser Folge lassen wir Sie nicht allein mit Ihren Gedanken und den Schlussfolgerungen zu diesem vielleicht gar nicht so ungewöhnlichen Tweet. Wir sind allerdings über diese reale Detektivgeschichte etwas auf die Schliche gekommen, das wir noch nicht auf dem Schirm hatten: Das Web steckt in mehr Dingen und Prozessen die uns umgeben. Das Internet of Things, die Vernetzung von Sensoren und Rechnern wächst und ergänzt Social Web, „unser“ menschliches Web. Und ist ähnlichen Bedrohungen ausgesetzt. Cyberattacken treffen auf „intelligente“, vernetzte Strassenlaternen, Kühlschränke, Toaster, Drucker und Kameras. Und Überraschung: Es braucht manchmal nur Geld und keine genialen Erkenntnisse, diese Attacken durchzuführen, seitdem es „Attack-as-a-Service“ zu kaufen gibt.

    Am Ende wird alles gut – wir erzählten eine wahre Geschichte und Sie wissen ein bisschen mehr, was Sie tun müssen, wenn Ihr Fahrzeug gewissen Anzeichen aufweist.

    Quellen

    Dr. Ken Tindell ist Experte für den CAN Bus, das Protokoll das die Kommunikation zwischen Bordrechner und „fast allem elektrischen und elektronischen“ im Fahrzeug sicherstellt.

    Eine gute Beschreibung, was CAN ist, findet sich auf Wikipedia:
    https://de.wikipedia.org/wiki/Controller_Area_Network

    Ken Tindells Bericht über den Cyberdiebstahl ist auf github und überschrieben mit:
    „CAN Injection: keyless car theft (CAN-Injektion: Schlüsselloser Autodiebstahl)„. https://kentindell.github.io/2023/04/03/can-injection/

    Nicolas Kaufmann titelte im „Stern“ am 13.4.2023 Mit Mobiltelefon oder Lautsprecher: Wie Diebe Autos über den Scheinwerfer in Minutenschnelle stehlen
    https://www.stern.de/auto/e-mobilitaet/autodiebstahl–wie-taeter-ueber-den-scheinwerfer-in-minutenschnelle-vorgehen-33367092.html

    IoT? Lesenswert der Beitrag von Julia Moßner / Linda Bergmann (2022) Internet of Things (IoT) – Definition, Technologie und Anwendung
    https://www.industry-of-things.de/internet-of-things-iot-definition-technologie-und-anwendung-a-878883/

    Was ist DNS? Eine gute Beschreibung und Visualisierung liefert diese Webseite
    https://kinsta.com/de/wissensdatenbank/was-ist-dns/

    Folgenbild

    Wir dachten an ein Bild von „Pferdediebstahl“ – ganz gut gefiel uns die Analogie zum Auto, am besten noch mit einem Bild von vor unserer Zeitenwende. Voila.

    Odysseus (mit dem Pilos-Hut) und Diomedes stehlen die Pferde des thrakischen Königs Rhesus, den sie gerade getötet haben. Apulische rotfigurige Situla, aus Ruvo, ca 360BC
    Quelle: https://commons.wikimedia.org/wiki/File:Rhesos_MNA_Naples.jpg

    Das war eine grausame Angelegenheit. Wir haben uns daher entschieden, mutig in die Zukunft zu schauen und einem Autodiebstahlsroboter bei seinem Treiben zuzusehen. Das Bild wurde in „DALL°E2 generiert, der Prompt war „colorful painting in comic style of a steel style robot stealing a car„. Der Prompt ist schon etwas poetisch, finden wir.

  • ChatGPT. Willkommen im Mittelalter?

    ChatGPT. Willkommen im Mittelalter?

    (S2/E11) Alle Welt spricht über ChatGPT. achwasfm.janlucash.com/ hat mit ChatGPT gesprochen, gespielt, gescherzt und philosophiert. Zusammen rausgefunden, wer die Fritten erfunden hat und wie man 5.klässlern Statistik beibringt.
    Nicht nur das: Wie unerschütterlich vertritt sie/er/es die durch Millionen und aber Millionen Quellen gebildete Meinung? Nach einer halben Wochen des "Zusammenlebens" erst dann waren wir bereit für diese ChatGPT Folge von achwasfm.janlucash.com/. Und wir gestehen – kaum war die Folge aufgenommen gab es schon Neues zu berichten.
    Unser Fazit: Beobachten!

    Warnhinweis: Wissen über und von ChatGPT entwickelt sich. Glauben Sie nichts, recherchieren Sie selbst. Ende des Warnhinweises.
    Die Mission der Muttergesellschaft:
    „OpenAI ist ein Unternehmen für KI-Forschung und -Einsatz. Unsere Mission ist es, sicherzustellen, dass künstliche allgemeine Intelligenz der gesamten Menschheit zugutekommt.“

    Was genau ist ChatGPT? Einer dieser putzigen, teils nützlichen oder auch nervigen Chat-Bots, die als erste Ansprechpartner im Web unsere Fragen und Wünsche bedienen? Wenn die Suche nix ergab und die Hotline belegt war? Ganz gewiß nicht.

    Hier, verehrtes Publikum, habe Sie es mit einem Giganten, einer Gigantin zu tun. Die genaue Menge an Quellen und Daten wird nicht genau genannt. Die Schätzung im Web: am 5.2.2023: ca. 300 Mrd. Wörter von frei zugänglichem Wissen des Webs, Büchern, Artikeln, Dokumenten wurden „eingelesen“; von echten Menschen mit niedriger Entlohnung in Sweat-Shops (und psychischen Folgen) von Üblem und Grausamkeiten befreit.

    Dann wurde das Ganze gespeichert und auffindbar abgelegt. Auffindbar bedeutet: ChatGPT findet Texte ohne langes Suchen: Z.B. über das Wort „Kartoffeln“ kommt man sowohl in die Kategorie Rezepte (Kartoffelsalat), in die Flora (die Pflanze), die Fauna (Kartoffelkäfer), die Geschichte (der Alte Fritz), Technik (Kartoffelstärke als Kleber). Es ist keine Keywordsuche, sondern kennt Texte.
    Die Ergebnisse werden dann nach einer genialen Regel ausgegeben: Passend zur Frage rät ChatGPT, was es am wahrscheinlichsten antworten soll. Das erinnert ein wenig an Prüfungen mit wohlwollendem Lehrpersonal, die mit Kopfnicken oder Vorsagen die richtige Antwort hervorlocken. Es wird berechnet, welches Wort wohl als nächste käme und die passenden Pronomen oder Artikel oder Adjektive etc. werden dazu gepackt. Und weitere, immer passende Texte dazu gemischt.
    Dabei helfen etwas 175 Mrd. „Neurone“, ein Mensch hat nach neuester Forschung etwa 90 Mrd. davon.*


    „Wozu kann ich „es“ nutzen?“ Quelle: Selbstauskunft des Tools vom 3.2.2023
    ChatGPT kann für viele Zwecke genutzt werden, einschließlich:

    1. Konversation: Du kannst mit ChatGPT Smalltalk führen oder Fragen stellen.
    2. Informationsbeschaffung: Du kannst ChatGPT nach Informationen über ein bestimmtes Thema fragen, z. B. Geschichte, Technologie, Geographie usw.
    3. Übersetzung: Du kannst ChatGPT nach Übersetzungen von Wörtern oder Sätzen fragen, die in einer bestimmten Sprache geschrieben sind.
    4. Schreibvorschläge: Du kannst ChatGPT um Schreibvorschläge für eine bestimmte Aufgabe bitten, z. B. eine E-Mail, einen Lebenslauf oder ein Essay.
    5. Generieren von Inhalten: Du kannst ChatGPT um die Generierung von Texten, Listen oder anderen Arten von Inhalten bitten.

    Wer steckt dahinter: Zum einen stammt chatGPT wie das an anderer Stelle („Clickbait“ S2/E06) schon vorgestellte „Zeichenprogramm“ DALL-E 2 aus dem Hause „OpenAI“. Wobei OpenAI inzwischen eher einer Wohnanlage mit frei zugänglichen Räumen und immer mehr werdenden abgeschlossenen Gebieten ist. Gründer waren 2015 waren unter anderen Elon Musk, Peter Thiel, Sam Altman. Elon Musk schied 2018 aus dem Vorstand aus, begleitet das Projekt weiterhin.

    Sam Altman ist inzwischen CEO des Unternehmens.

    Die News (bis zum 5.2.2023)

    • Großes Interesse hat Microsoft bekundet – unter anderem mit einem Invest von 10 Mrd$ am 23.1.2023. Ergebnis: Die Version ChatGPT-3 ist exklusiv MS vorbehalten.
    • Am 1.2.2023 wurde die Abo Version „ChatGPT PLUS“ verkündet. Für 20$ im Monat bekommt man u.a. den Vorzug einer immer erreichbaren Version (ohne Timeout bei Überlast). Gilt nicht in Deutschland.
    • Die Anzahl der Nutzer soll inzwischen (2.2.2023) bei > 100.000.000 liegen.
    • Die Kosten für den Betrieb werden auf 100.000$ pro Tag geschätzt
    • Die Anzahl eingelesener Wörter liegt bei ca. 300 Milliarden – bis Ende 2021. Alles Wissen danach (also ab 2022) ist noch nicht eingelesen.

    Weshalb dieser Titel der Folge?

    Die geneigte Leserschaft könnte noch eine Erklärung zum Folgentitel erwarten: „Willkommen im Mittelalter?“ ChatGPT hat eine für Wissenschaftler unangenehme Eigenschaft: Es sagt nicht, woher es etwas weiß, es gibt partout keine Quellenangaben sondern erzählt von der Fülle und dem großen Ganzen. Noch.
    Die Kunst des Zitierens mit Quellenangabe wurde systematisiert und verbindlich erst in der Renaissance (17. Jhd.) entwickelt.

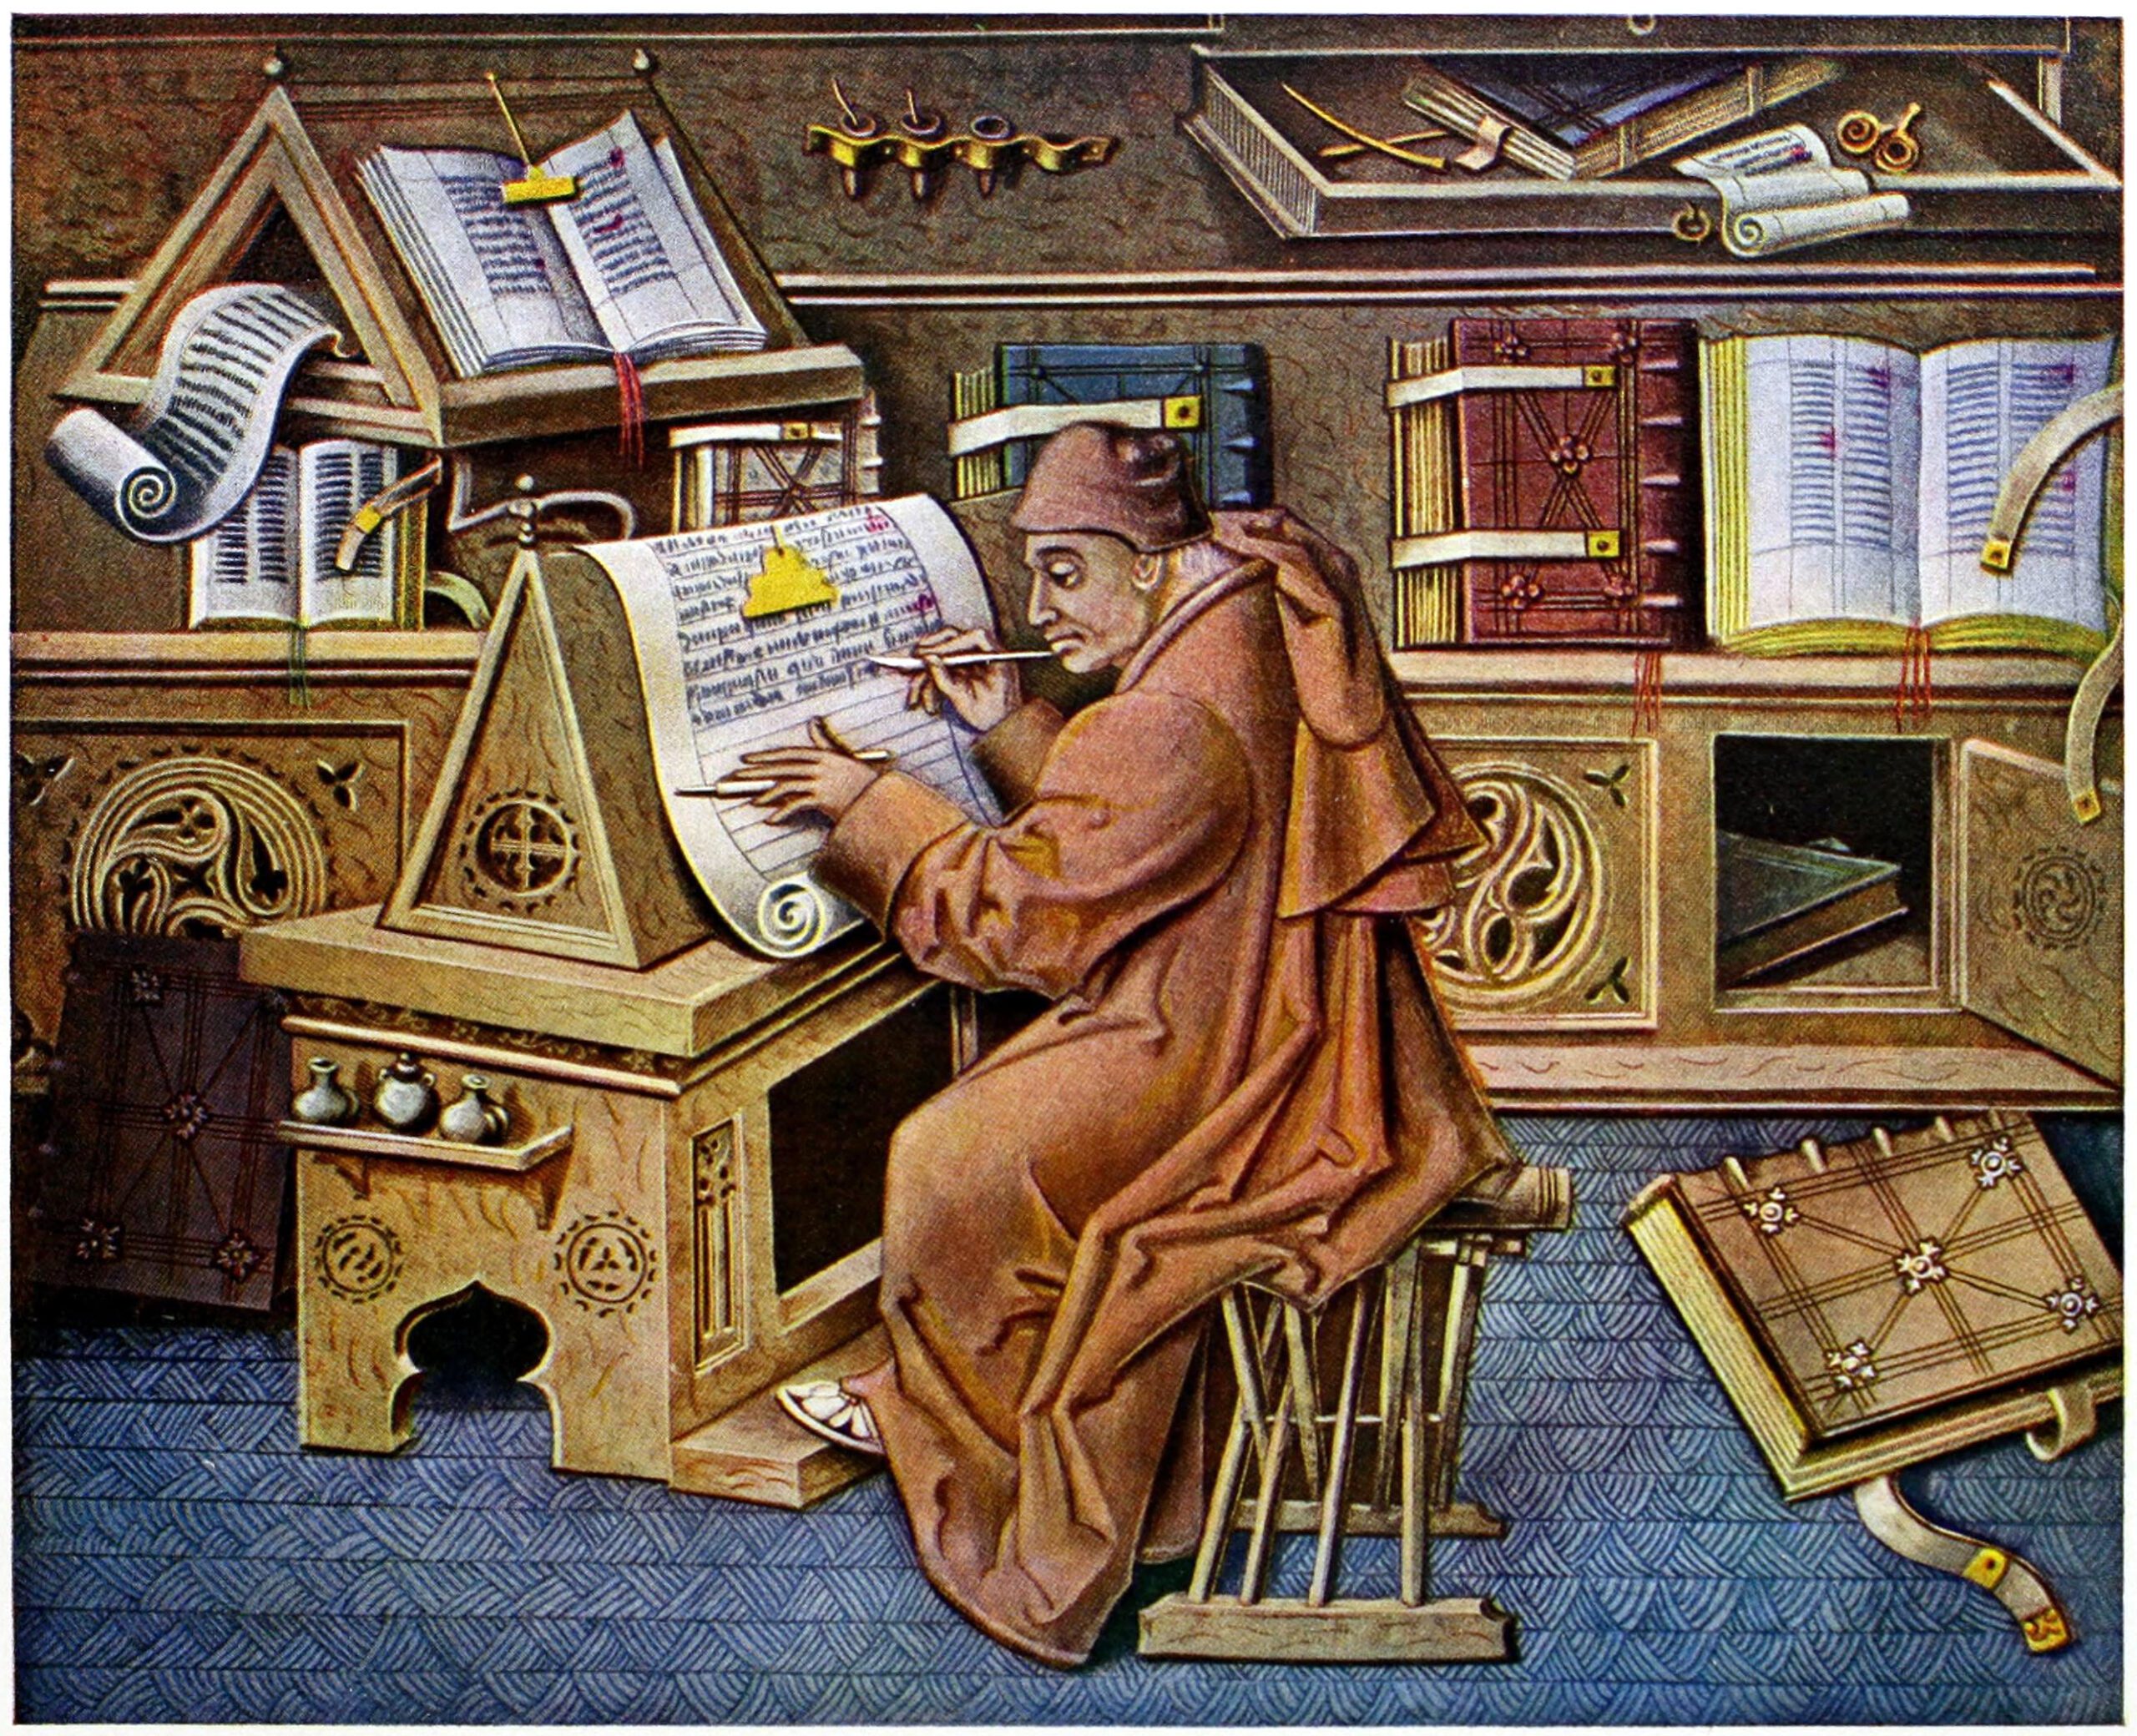
    Daher passen Titel und Folgenbild (aus dem 15. Jhd) gut zusammen. Siehe Abschnitt Episodenbild.

    Quellen

    • Der Witz im Wortlaut, geeignet für die Analyse im Deutschunterricht (Quelle: Chat-GBT, V. 2. 9. Jan. 2023, Deutscher Prompt, geschrieben von Autor (HWK)
      Prompt: „Erzähle einen Witz von einer LED und einer Glühlampe, die sich in einer Kneipe begegnen.“
      Antwort: Okay, hier ist ein Witz über eine LED und eine Glühlampe, die sich in einer Kneipe begegnen:
      • Eines Tages treffen sich eine LED und eine Glühlampe in einer Kneipe. Die LED sagt zur Glühlampe: „Hey, warum bist du so warm?“
      • Die Glühlampe antwortet: „Ich arbeite hart, um Licht zu produzieren.“
      • Die LED sagt daraufhin: „Nun, ich produziere dasselbe Licht und verbrauche viel weniger Energie. Ich denke, ich habe den besseren Job.“
        Die Glühlampe antwortet: „Kann sein, aber ich bin warmherzig.“

    • ChatGPT – Selbstauskunft, Versionsinfo und Hilfe.
      https://help.openai.com/en/collections/3742473-chatgpt

      Darin auch dieser Beitrag:
      Why did ChatGPT give me an answer that’s not related to my question?
      ChatGPT will occasionally make up facts or “hallucinate” outputs. If you find an answer is unrelated, please provide that feedback by using the „Thumbs Down“ button.

      Und diese Warnung:
      Can I trust that the AI is telling me the truth? ChatGPT is not connected to the internet, and it can occasionally produce incorrect answers. It has limited knowledge of world and events after 2021 and may also occasionally produce harmful instructions or biased content.We’d recommend checking whether responses from the model are accurate or not. If you find an answer is incorrect, please provide that feedback by using the „Thumbs Down“ button.
      https://help.openai.com/en/collections/3742473-chatgpt
    • * „Das Gehirn eines Menschen neueren Untersuchungen hat im Schnitt 86 Milliarden[38] Nervenzellen.
      Quelle:
      Suzana Herculano-Houzel*The human brain in numbers: a linearly scaled-up primate brain
      in
      „Frontiers in Human Neuroscience„. 9.9.2009
      https://www.frontiersin.org/articles/10.3389/neuro.09.031.2009/full
    • Hallo Hörende von achwasfm.janlucash.com/. Wir versuchen Ihnen an dieser Stelle zukünftig Updates anzubieten. Da das Thema brennt (volatil, dynamisch) ist, Bitten wir Sie um Mithilfe, wenn sie Unerhörtes, eigene Erahrungen und Rückmeldungen zum Thema geben möchten.
      Bitte schreiben Sie an „info ät achwas punkt fm“ und teilen Sie uns ihre Erfahrungen mit.
      Besten Dank.

    Das Episodenbild 

    Titel des Folgenbildes: „Schreiber bei der Arbeit an einem Manuskript, umgeben von seinem Forschungsmaterial“. Diese Arbeit ist undatiert – könnte nach 1454–1457 entstanden sein.
    Zeichner des Bildes ist Jean Le Tavernier, er ein zu seiner Zeit bekannter flämischer Buchmaler. In dieser Zeit arbeitete er mit Jean Miélot zusammen, der auf der Illustration dargestellt ist. Jean Miélot war Schreiber, Autor, Übersetzer, Rechercheur, Zeichner und Priester. Und betrieb eine angesehene Schreib- und Zeichen-Werkstatt,

    Quelle

    https://commons.wikimedia.org/wiki/File:Escribano.jpg

    Status 5.2.2023, 23:28

  • Nur Katzengold am Ende des Regenbogens? Daten nutzen.

    Nur Katzengold am Ende des Regenbogens? Daten nutzen.

    (S1/E39) Daten. Sie sind das neue Öl – oder passender: Das Neue Gold. Das Data-Mining nimmt immer mehr die Züge eines Goldrausch an. Big Data versprechen noch mehr, als nur Daten. Startups wachsen aus dem Boden und erreichen als „Unicorns“ Milliardenwerte an den Börsen. Wir stellen uns heute der Frage, ob die Analogie zum Goldrausch trägt? Oder lassen wir uns nur von dem Ursprung beider “Mining Gebiete” (Gold, Data Driven Companies), dem Staate Kalifornien, zu einem Trugschluß verführen?


    Was erwartet uns am Ende des Regenbogens – wirklich der Goldtopf, oder nur Pyrit, auch Narren- oder Katzengold genannt? Es kommt darauf an, aus welcher Perspektive man die Angelegenheit betrachtet: Wer macht das Geld? Vielleicht die Hersteller von Hardware, Servern, Netzen, Analysesoftware. Oder auch die Unternehmen, die dieses Equipment einsetzen, um die eigenen Daten zu analysieren. Aber: haben sie denn die Daten, die sie brauchen? Können Sie die richtigen Fragen stellen, um Gold regnen zu lassen?

    Wir werden uns auch um die Frage kümmern, wo wie viel Datengold zu finden ist, und ob dieses adäquat geschürft, gewaschen und geschmolzen werden kann, damit „man“ es wirklich nutzen kann.

    Antworten auf unsere Fragen fanden wir unerwartet auch bei einem Anbieter von Software und Beratungen, dessen Produkte „Gotham“ und „Foundry“ heissen, bei Palantir. Sagenumwoben? Das würde zum Gesamtbild passen.

    Eine Schlußfolgerung sei bereits an dieser Stelle bekannt gemacht: Big Data sorgt oft nicht für mehr Wissen, sondern für höhere Umsätze. Und wenn aus Daten geschöpfte Wissensnuggets ungenutzt bleiben, haben sie den Wert von – Katzengold.

    Quellen zur Episode (aktualisiert am 13.6.2022 zu Palantir)

    DATUMIZE – ein Anbieter von Hardware erklärt „Dark Data“ und verweist auf die passende IBM Studie. Quelle abgerufen am 11.6.2022, 19:30
    https://blog.datumize.com/evolution-dark-data

    David Lazer, Ryan Kennedy, Gary King, and Alessandro Vespignani:
    The Parable of Google Flu: Traps in Big Data Analysis
    2014. Science, 343, 14 March, Pp. 1203-1205. Copy at https://tinyurl.com/y3r58os
    Originalquelle in SCIENCE:
    https://www.science.org/doi/10.1126/science.1248506

    BMW Smart Data Analytics: Industrie 4.0 / Digitalisierung
    Beispiele der tatsächlichen Nutzung von Daten in der Produktion/ Fertigung von Fahrzeugen: Vermessene und gekennzeichnete Bleche steuern Blechpressen und erhöhen die Qualität und Lebensdauer. Einen Einblick in diese gelungene Digitalisierung ermöglicht BMW auf dieser Webseite:
    Lasermarkierte Karosserieteile: Feinsteuerung der Pressen, jederzeit verfolgbare Karosserieteil
    https://www.press.bmwgroup.com/deutschland/article/detail/T0273931DE/smart-data-analytics:-die-bmw-group-setzt-auf-intelligente-nutzung-von-produktionsdaten-fuer-effiziente-prozesse-und-premiumqualitaet

    Häufigste Todesursache 2021 in den USA bei Kindern und Jugendlichen: Schußwaffengebrauch. Quelle FAZ abgerufen am 12.6. 2022, 19:21
    https://www.faz.net/aktuell/gesellschaft/usa-schusswaffen-sind-nun-die-haeufigste-todesursache-von-kindern-17973578.html

    Palantir in der Presse (Quellenabrufe am 12.6.2022 und 13.6.2022*)

    Meldung der Tagesschau am 3.6.2022* Schafft die Polizei den gläsernen Bürger?
    Nach Hessen, NRW und Bayern prüfen der Bund und weitere Bundesländer den Einsatz des Polizei-Analysetools der US-Firma Palantir, wie BR-Recherchen zeigen. Datenschützer stufen die Software als problematisch ein.
    https://www.tagesschau.de/investigativ/br-recherche/polizei-analyse-software-palantir-101.html

    FAZ Gespräch mit Jan Hiesserich, Palantir Strategie Europa (Paywall)
    https://www.faz.net/aktuell/wirtschaft/digitec/warum-palantir-ein-unternehmen-fuer-krisenzeiten-ist-17919386.html

    10xDNA Research Prozess (Frank Thelen): Inside Palantir. Gespräch mit Jan Hiesserich, Palantir Strategie Europa
    https://youtu.be/XEVYOf0LLTg

    Yahoo Finance
    https://de.finance.yahoo.com/nachrichten/geheimnisvolle-palantir-konzern-peter-thiel-074800082.html

    Zum Episodenbild

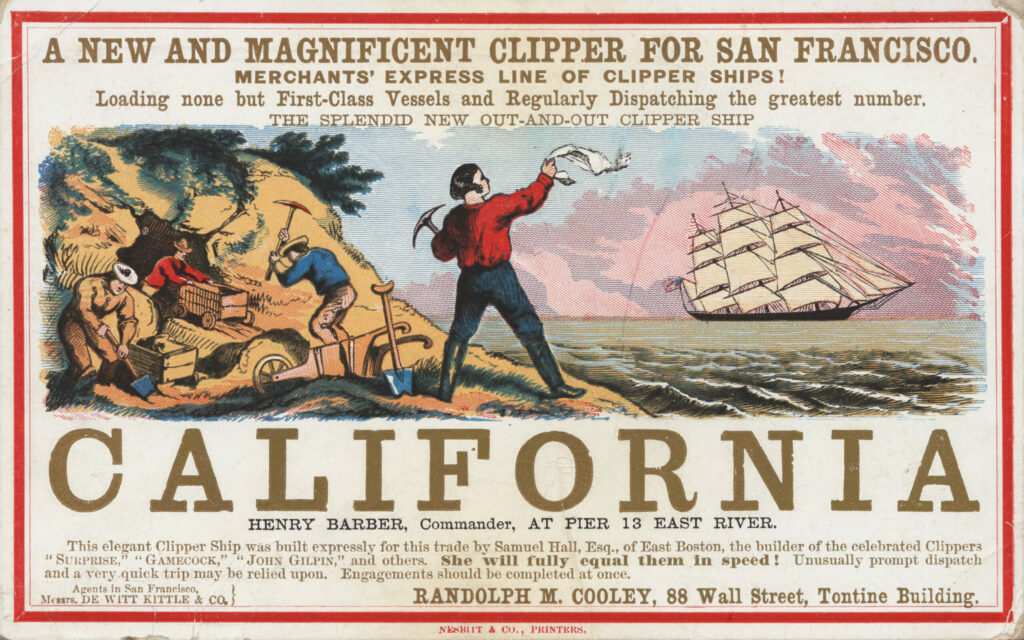
    Das Episodenbild zeigt eine Segelkarte, also ein Ticket einer Transport-Company, die mit dem Hinweis wirbt, wie schnell und sicher kalifornische Häfen angesteuert werden. Geworben wird mit Bildern, den „Impressionen“ aus dem Alltag der Goldgräber. Im Bild über der Beschriftung, zwischen dem „I“ und dem „F“ des Schriftzuges „CALIFORNIA“ ist die berühmte blitzblanke Schaufel, das Standardwerkzeug der Goldgräber:innen, zu sehen.

    Das Bild stammt von dem Drucker der Segelkarte, G.F. Nesbitt & Co. und ist auf das Jahr 1850 datiert.

    Die vollständige Unterschrift:
    „A NEW AND MAGNIFICENT CLIPPER FOR SAN FRANCISCO. MERCHANT’S EXPRESS LINE OF CLIPPER SHIPS! Loading none but First-Class Vessels and Regularly Dispatching the great number. THE SPLENDID NEW OUT-AND-OUT CLIPPER SHIP CALIFORNIA, HENRY BARBER, Commander, AT PIER 13 EAST RIVER . This elegant Clipper Ship was built expressly for this trade by Samuel Hall, Esq., of East Boston, the builder of the celebrated Clippers “SURPRISE,” “GAMECOCK,” “JOHN GILPIS,” and others, She will fully equal them in speed!
    Unusually prompt dispatch and very quick trip may be relied upon. Engagements should be completed at once. Agents in San Francisco. Msmmrs, DE WITT KITTLE & CO. RANDOLPH M. COOLEY, 88 Wall Street, Tontine Building“

    https://commons.wikimedia.org/wiki/File:California_Clipper_500.jpg

    Nachweis Wikimedia
    https://commons.wikimedia.org/wiki/File:California_Clipper_500.jpg

  • Von menschlicher und künstlicher Intelligenz.

    Von menschlicher und künstlicher Intelligenz.

    (S1/E37) Künstliche Intelligenz? Sind das nicht die Roboter, die uns beherrschen werden, die schlauer sind als Menschen? So wie in den Science Fiction Filmen? Nicht nur, denn es gibt derer zwei. Wir haben uns einerseits fleissige Helferlein geschaffen, die geistige Arbeiten erledigen können. Die schlau, aber nicht klug sind. Und weil sie immer schlauer werden und manches schneller können als wir, haben wir auch ein wenig Angst. Davor, dass sie klug und klüger werden.

    Und uns überflüssig machen – nicht nur unseren Arbeitsplatz, sondern uns vielleicht sogar als Spezies ersetzen könnten. Aber das ist eine andere KI. Die zweite Sorte.

    Mit dieser KI könnten wir was erleben. Wie das zu verstehen ist, und wie KI überhaupt zu verstehen ist, erzählen wir in dieser Folge 37. Die uns als Menschen auch ein wenig klüger macht.

    Quellen zur Episode

    BITKOM (Hrsg), DFKI: Künstliche Intelligenz. Wirtschaftliche Bedeutung, gesellschaftliche Herausforderungen, menschliche Verantwortung (2017)

    Ray Kurzweil: Menschheit 2.0. Lola Books, (2013). engl. Originaltitel: The Singularity Is Near.

    BBC: Kenya alarm after carrier bag mistaken for stray lion, https://www.bbc.com/news/world-africa-61335539 (abgerufen 15. Mai 22 17:30)

    Ein satirisches, kenntnisreiches, philosophisches Werk über eine mögliche Zukunft mit KI.
    Marc Uwe Kling: QualityLand (dunkle Edition). Ullstein (2017)
    Marc-Uwe Kling: QualityLand (helle Edition). Ullstein (2017)
    Marc-Uwe Kling: QualityLand 2.0: Kikis Geheimnis. Ullstein, (2020)

    Zum Episodenbild

    Das Episodenbild zeigt eine Schale mit Zitronen und Wespe von Giovanna Garzoni (1600 – 1670), einer italienische Künstlerin der Barockzeit. Das Bild entstand vermutlich „Ende der 1640er“ Jahre.

    Die Wespe müsste bei der Analyse des Bildes durch eine Künstliche Intelligenz auffallen. Und diese zugleich verwirren, wenn sie sich in der Malerei des 15. Jahrhunderts auskennt. Was anzunehmen ist. Denn was zu erkennen glaubt, wäre eine Fliege: Die gemalte Fliege, Musca Depicta, geht auf eine Tradition altniederländische Maler zurück: Es war nicht unüblich, eine Fliege als Optische Täuschung in das Bild oder auf dem Rahmen einzufügen. Es konnte eine Anspielung sein auf Beelzebub, den Herrn der Fliegen, das Böse, das sich im Unscheinbaren versteckt. Wahrscheinlicher war, dass die gemalte Fliege zeigen sollte, welche Kunstfertigkeit im Detail die Künstler:innen hatten, denn viele Betrachter:innen hielten die Fliege für „echt“.

    Nachweis Wikimedia
    https://de.wikipedia.org/wiki/Giovanna_Garzoni#/media/Datei:Giovanna_Garzoni_(Italian)-_Still_Life_with_Bowl_of_Citrons-_Google_Art_Project.jpg

  • Suchet und ihr werdet gefunden. Die andere Google Story.

    Suchet und ihr werdet gefunden. Die andere Google Story.

    (S1/E06) Wer suchet, der findet? Sie glauben, schon alles über Google zu wissen? Wir betrachten in dieser Folge den Segen guter Suchmaschinen und blicken unter die Motorhaube von Google. Aber da ist mehr: Die Entwicklung von Google ist eine Parabel für die Entwicklung des Internets. Würde Thomas Mann heute lebend die Geschichte von Google als Prequel zu seinen „Buddebrooks“ schreiben? Als nur Suchende wissen wir wenig, wie die Rechenregeln von Google lauten, um relevante Ergebnisse für unsere machmal schnell hingetippten Eingaben zu finden. Und uns kümmert noch weniger, was Google tut, um unsere Suchen zu finanzieren. Ist ja für uns kostenlos. Oder?

    1995 treffen sich Larry Page und Sergey Brin, um gemeinsam eine Forschungsarbeit zum Thema „Suche im Web“ an der Stanford University zu schreiben. Die Arbeit ist ausgezeichnet und wird zum Patent angemeldet. Larry Page beginnt darüber seine Doktorarbeit – die er nie abschliesst: Der Inhalt ist zu brisant. Sie enthält „die Google Formeln“, die eine Suche effektiv und relevant machen.

    Zum Teil sind diese Formeln immer noch geheim, zum Teil wurden sie „geknackt“. Denn mit dem Erfolg von Google beginnt ein Wettlauf ganz im Sinne eines Räuber-Beute Schemas: Glaubte Google die Finanzierung der Suche über inhaltlich passende „Ads“ (Werbeeinblendungen) sichergestellt zu haben, gab es kluge Köpfe, die rausgefunden haben, wie man, anstatt für Ads zu zahlen, die Webseiten „suchoptimiert“.

    Die Geschichte von Google selbst liest sich wie ein großes Experiment, ein A/B-Testing: So erfindet Google in 26 Jahren immer neue Tarifmodelle, Werbeformate und Tools, um mehr über uns zu erfahren. Und kreiert das Meta-Google Unternehmen Alphabet, eine Art Weltwissen-Maschine.

    Die Geschichte zum Beitragsbild

    Das Bild stellt einen Google Vorfahren aus dem 19. Jahrhundert dar: „Der Bibliothekar“ von Carl Spitzweg (um 1850) zeigt einen Suchenden in seiner Bibliothek. Er hat wohl schon Ergebnisse gefunden und versucht gerade einen neuen Text auf Relevanz für sein Thema zu prüfen.

    Gedankenspiel: Wenn dies ein hauptberuflicher Bibliothekar wäre, der nicht für seine Suchen entlohnt würde, finge er vielleicht an, den ausgeliehenen Büchern kleine „Werbezettel“ für die örtliche Metzgerei oder die Pfarrei beizufügen? Würde er sich notieren, wer welche Bücher entleiht, um bessere Empfehlungen zu geben? Oder würde er diese Information an die Apothekerin oder den Lebensmittelhändler verkaufen, um das „Einkaufserlebnis“ der Lesenden „angenehmer“ zu gestalten?

    Carl Spitzweg malte und verkaufte acht zum Teil ähnliche Fassungen des „Bibliothekars“, die erste davon etwa um das Jahr 1845 mit dem bekannteren Titel „Der Bücherwurm“. https://commons.wikimedia.org/wiki/File:Carl_Spitzweg_021.jpg

    Quellen:

    Die Geschichte von Google „in einer Nussschale“
    Die Geschichte von Google ist sehr gut auf Wikipedia beschrieben. Viele der Fakten im Podcast finden sich dort auch – und noch weitergehende Stories und Trivia.
    https://de.wikipedia.org/wiki/Google_LLC

    WDF*IDF
    Diese Formel existiert schon seit 1992 als eine Möglichkeit, Dokumente (auch Websites sind Dokumente) nach relevanten Inhalten in ihrer Bedeutung in eine Rangfolge zu bringen („zu ranken“).

    Der Artikel von Wikipedia ist kurz, weisst auf die Erfinderin, Donna Harman, hin und enthält die Formel. https://de.wikipedia.org/wiki/Within-document_Frequency

    Die folgende Website enthält einen WDF*IDF Rechner für Webseiten.
    Wer immer schon mal das ohne eigenes Programmieren ausprobieren wollte – hier gelingt es. Und erklärt die Formeln gut und verständlich.
    https://www.wdfidf-tool.com

    Zitationsindex
    Der 2. Teil der Google Rechenregeln bewertet die Relevanz der Webseite (wie häufig wird eine Seite zitiert („Backlinks“, „verlinkt“) von anderen Seiten. Diese werden um so höher gewichtet, je bedeutsamer sie sind).
    Wie in der Folge besprochen: Auch dieses Verfahren war in der Wissenschaft schon vor Google bekannt als „Zitationsindex“ von Büchern .
    Um zu zeigen, wie das aussieht, haben wir den Zitationsindex von Donna Harman zu ihrem Buch von 1992 „Ranking Algorithms“ verlinkt. Genau, das ist das Buch, in dem ein Teil der „Gottesformel“ beschrieben steht. Der Link zeigt auf „Google Scholar“, der Google Suchmaschine für wissenschaftliche Texte. Die eben diesen Algorithmus verwendet.
    https://scholar.google.com/citations?view_op=view_citation&hl=en&user=0lic4McAAAAJ&citation_for_view=0lic4McAAAAJ:fQNAKQ3IYiAC

    Sorry, this is „gibberish“!
    Gibberish entspricht den deutschen Ausdrücken „Geschwafel, Gefasel, Geschwurbel“.“… calculating a gibberish score for the resource using the language model score and the query stuffing score; and using the calculated gibberish score to determine whether to modify a ranking score of the resource.“
    Das Google Patent zum Erkennen von „Geschwafel“ befindet sich auf der Website mit den Google Patenten.
    https://patents.google.com/patent/US8554769B1/en

    Dazu passend:
    Die Surprise Website der Woche: mit „Super-Dooper Content inkl. Suchmaschinen Optimierung“
    Ausprobieren: Generiere eine suchmaschinenoptimierte esoterische Webseite mit Text, Bild und Kommentaren. Gibberish auf Knopfdruck. https://sebpearce.com/bullshit/

    Alphabet und alpha-bet: aus einem Brief von Larry Page und Sergey Brin:
    „…For Sergey and me this is a very exciting new chapter in the life of Google—the birth of Alphabet. We liked the name Alphabet because it means a collection of letters that represent language, one of humanity’s most important innovations, and is the core of how we index with Google search! We also like that it means alpha‑bet (Alpha is investment return above benchmark), which we strive for! I should add that we are not intending for this to be a big consumer brand with related products—the whole point is that Alphabet companies should have independence and develop their own brands….“
    https://abc.xyz

    Google Sicherheit Zitat: „Technologie für alle zu entwickeln – das bedeutet auch, alle zu schützen, die sie nutzen. Unsere Datenschutz- und Sicherheitstechnologien schützen nicht nur unsere Nutzerinnen und Nutzer sondern fördern auch Innovationen in der Branche.“
    https://safety.google/intl/de/security/security-leadership/

    FLoC „Google hat seine neue Technologie Federated Learning of Cohorts (FLoC) nun gestartet. Mit dieser sollen die unbeliebten Tracking-Cookies verschwinden und trotzdem zielgerichtete Werbeschaltungen möglich sein. Statt einen einzelnen Nutzer durch das Netz zu verfolgen und seine Interessen aus diesem Profil abzuleiten, sollen die User nun größeren Interessens-Gruppen zugeordnet werden.“
    https://datenschutzbeauftragter-hamburg.de/2021/04/googles-cookie-ersatz-floc-aus-datenschutzsicht-eine-verbesserung/

    https://winfuture.de/videos/Internet/FLoC-So-funktioniert-Googles-Ersatz-zum-unbeliebten-Tracking-Cookie-22581.html

    Zeitgenössisches über „Suchmaschinen“ – was davon gilt heute noch?
    http://www.kommdesign.de/links/suchmaschinen.htm

    kaesekuchen.de gibt es wirklich
    In dieser Folge wird mehrfach die kaesekuchen.de erwähnt. Als URL spontan während der Aufnahme entstanden, um Methoden der Suche zu illustrieren.
    Nun: Es gibt diese Seite wirklich. Ist eine nicht kommerzielle Seite, auf der man viele Käsekuchen Rezepte findet. Der Besitzer (aus Bonn) der Seite hat uns die Verlinkung gestattet. Wie klein ist die Welt…

  • Wir wissen nicht, was sie tun: Maschinelle Autokorrekturen

    Wir wissen nicht, was sie tun: Maschinelle Autokorrekturen

    (Folge 4, 02.07.2021) Autokorrekturen können lustig, lästig und nützlich sein. Aber was passiert, wenn ein Industrie-Scanner Konstruktionszeichnungen, Steuererklärungen oder Dokumente eigenmächtig verändert? Wie kommt es, dass dieser Software Fehler auch Jahre nach der Entdeckung immer noch sein Unwesen in den Geräten treibt?

    Ausgangspunkt dieser Folge sind Scanner, die „halluzinieren“ und Muster erkennen, die es so nicht gibt. Wir begeben uns auf die Spuren von scheinbar intelligenten Produkten und berichten über die Fallstricke der digitalen Transformation unseres Lebens.

    Denn als Nutzer digitalisierter Produkte wie Smartphones, Autos oder Scannern wissen die meisten von uns nicht, wie genau diese funktionieren, welche Algorithmen (Rechenregeln) uns gerade ihre Ergebnisse präsentieren oder in von uns anders gewollte Abläufe eingreifen.

    Und wir kommen auf den Hund – und erfahren, was die Versuche, die unterschiedlichen Hunderassen maschinell auseinander zu halten, mit Scannern, Autos und Smartphones zu tun haben.

    Bildquelle

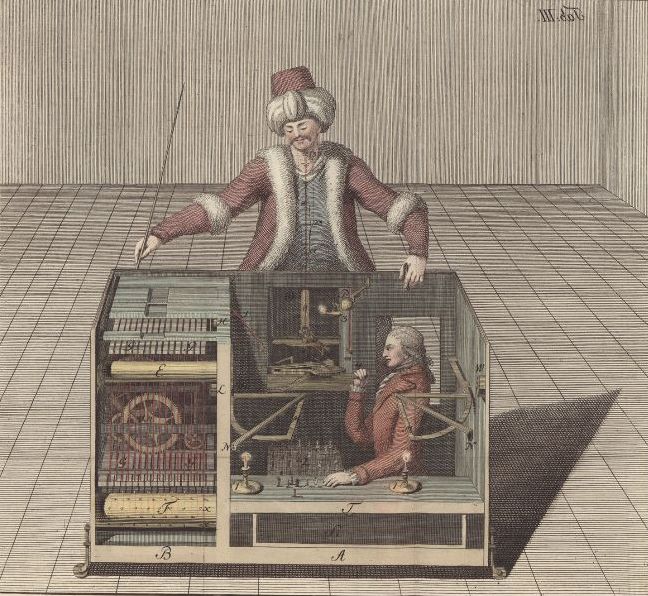
    Das Beitragsbild zeigt ein Wunderwerk der Technik aus dem 18. Jhd. Sein Erfinder, Wolfgang von Kempelen erzeugte bei den Zuschauern den Eindruck, dass dieser Apparat tatsächlich Schach spielen könne. In Wirklichkeit verbarg sich in der Maschine ein Schachmeister, der eine höchst komplexe Maschine bediente. Der Schwindel flog erst spät auf, die Algorithmen waren tief im System verborgen.

    https://commons.wikimedia.org/wiki/File:Racknitz_-_The_Turk_3.jpg

    Quellen