Autor: jalu

  • Suchet und ihr werdet gefunden. Die andere Google Story.

    Suchet und ihr werdet gefunden. Die andere Google Story.

    (S1/E06) Wer suchet, der findet? Sie glauben, schon alles über Google zu wissen? Wir betrachten in dieser Folge den Segen guter Suchmaschinen und blicken unter die Motorhaube von Google. Aber da ist mehr: Die Entwicklung von Google ist eine Parabel für die Entwicklung des Internets. Würde Thomas Mann heute lebend die Geschichte von Google als Prequel zu seinen „Buddebrooks“ schreiben? Als nur Suchende wissen wir wenig, wie die Rechenregeln von Google lauten, um relevante Ergebnisse für unsere machmal schnell hingetippten Eingaben zu finden. Und uns kümmert noch weniger, was Google tut, um unsere Suchen zu finanzieren. Ist ja für uns kostenlos. Oder?

    1995 treffen sich Larry Page und Sergey Brin, um gemeinsam eine Forschungsarbeit zum Thema „Suche im Web“ an der Stanford University zu schreiben. Die Arbeit ist ausgezeichnet und wird zum Patent angemeldet. Larry Page beginnt darüber seine Doktorarbeit – die er nie abschliesst: Der Inhalt ist zu brisant. Sie enthält „die Google Formeln“, die eine Suche effektiv und relevant machen.

    Zum Teil sind diese Formeln immer noch geheim, zum Teil wurden sie „geknackt“. Denn mit dem Erfolg von Google beginnt ein Wettlauf ganz im Sinne eines Räuber-Beute Schemas: Glaubte Google die Finanzierung der Suche über inhaltlich passende „Ads“ (Werbeeinblendungen) sichergestellt zu haben, gab es kluge Köpfe, die rausgefunden haben, wie man, anstatt für Ads zu zahlen, die Webseiten „suchoptimiert“.

    Die Geschichte von Google selbst liest sich wie ein großes Experiment, ein A/B-Testing: So erfindet Google in 26 Jahren immer neue Tarifmodelle, Werbeformate und Tools, um mehr über uns zu erfahren. Und kreiert das Meta-Google Unternehmen Alphabet, eine Art Weltwissen-Maschine.

    Die Geschichte zum Beitragsbild

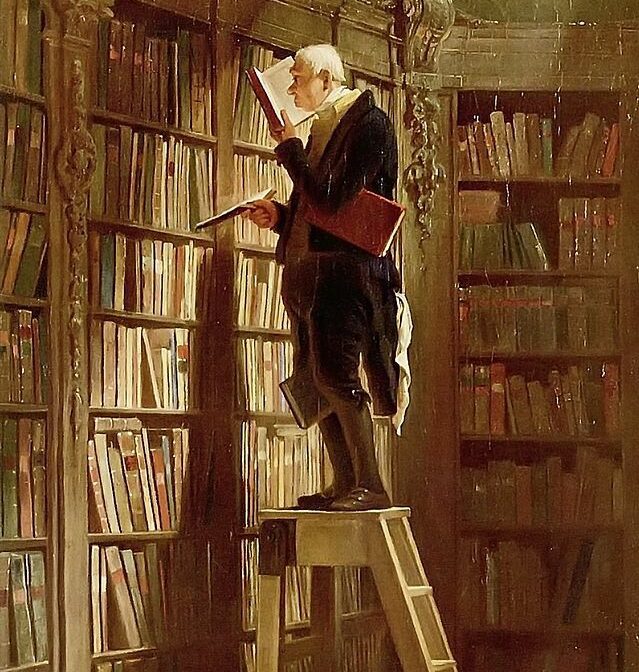
    Das Bild stellt einen Google Vorfahren aus dem 19. Jahrhundert dar: „Der Bibliothekar“ von Carl Spitzweg (um 1850) zeigt einen Suchenden in seiner Bibliothek. Er hat wohl schon Ergebnisse gefunden und versucht gerade einen neuen Text auf Relevanz für sein Thema zu prüfen.

    Gedankenspiel: Wenn dies ein hauptberuflicher Bibliothekar wäre, der nicht für seine Suchen entlohnt würde, finge er vielleicht an, den ausgeliehenen Büchern kleine „Werbezettel“ für die örtliche Metzgerei oder die Pfarrei beizufügen? Würde er sich notieren, wer welche Bücher entleiht, um bessere Empfehlungen zu geben? Oder würde er diese Information an die Apothekerin oder den Lebensmittelhändler verkaufen, um das „Einkaufserlebnis“ der Lesenden „angenehmer“ zu gestalten?

    Carl Spitzweg malte und verkaufte acht zum Teil ähnliche Fassungen des „Bibliothekars“, die erste davon etwa um das Jahr 1845 mit dem bekannteren Titel „Der Bücherwurm“. https://commons.wikimedia.org/wiki/File:Carl_Spitzweg_021.jpg

    Quellen:

    Die Geschichte von Google „in einer Nussschale“
    Die Geschichte von Google ist sehr gut auf Wikipedia beschrieben. Viele der Fakten im Podcast finden sich dort auch – und noch weitergehende Stories und Trivia.
    https://de.wikipedia.org/wiki/Google_LLC

    WDF*IDF
    Diese Formel existiert schon seit 1992 als eine Möglichkeit, Dokumente (auch Websites sind Dokumente) nach relevanten Inhalten in ihrer Bedeutung in eine Rangfolge zu bringen („zu ranken“).

    Der Artikel von Wikipedia ist kurz, weisst auf die Erfinderin, Donna Harman, hin und enthält die Formel. https://de.wikipedia.org/wiki/Within-document_Frequency

    Die folgende Website enthält einen WDF*IDF Rechner für Webseiten.
    Wer immer schon mal das ohne eigenes Programmieren ausprobieren wollte – hier gelingt es. Und erklärt die Formeln gut und verständlich.
    https://www.wdfidf-tool.com

    Zitationsindex
    Der 2. Teil der Google Rechenregeln bewertet die Relevanz der Webseite (wie häufig wird eine Seite zitiert („Backlinks“, „verlinkt“) von anderen Seiten. Diese werden um so höher gewichtet, je bedeutsamer sie sind).
    Wie in der Folge besprochen: Auch dieses Verfahren war in der Wissenschaft schon vor Google bekannt als „Zitationsindex“ von Büchern .
    Um zu zeigen, wie das aussieht, haben wir den Zitationsindex von Donna Harman zu ihrem Buch von 1992 „Ranking Algorithms“ verlinkt. Genau, das ist das Buch, in dem ein Teil der „Gottesformel“ beschrieben steht. Der Link zeigt auf „Google Scholar“, der Google Suchmaschine für wissenschaftliche Texte. Die eben diesen Algorithmus verwendet.
    https://scholar.google.com/citations?view_op=view_citation&hl=en&user=0lic4McAAAAJ&citation_for_view=0lic4McAAAAJ:fQNAKQ3IYiAC

    Sorry, this is „gibberish“!
    Gibberish entspricht den deutschen Ausdrücken „Geschwafel, Gefasel, Geschwurbel“.“… calculating a gibberish score for the resource using the language model score and the query stuffing score; and using the calculated gibberish score to determine whether to modify a ranking score of the resource.“
    Das Google Patent zum Erkennen von „Geschwafel“ befindet sich auf der Website mit den Google Patenten.
    https://patents.google.com/patent/US8554769B1/en

    Dazu passend:
    Die Surprise Website der Woche: mit „Super-Dooper Content inkl. Suchmaschinen Optimierung“
    Ausprobieren: Generiere eine suchmaschinenoptimierte esoterische Webseite mit Text, Bild und Kommentaren. Gibberish auf Knopfdruck. https://sebpearce.com/bullshit/

    Alphabet und alpha-bet: aus einem Brief von Larry Page und Sergey Brin:
    „…For Sergey and me this is a very exciting new chapter in the life of Google—the birth of Alphabet. We liked the name Alphabet because it means a collection of letters that represent language, one of humanity’s most important innovations, and is the core of how we index with Google search! We also like that it means alpha‑bet (Alpha is investment return above benchmark), which we strive for! I should add that we are not intending for this to be a big consumer brand with related products—the whole point is that Alphabet companies should have independence and develop their own brands….“
    https://abc.xyz

    Google Sicherheit Zitat: „Technologie für alle zu entwickeln – das bedeutet auch, alle zu schützen, die sie nutzen. Unsere Datenschutz- und Sicherheitstechnologien schützen nicht nur unsere Nutzerinnen und Nutzer sondern fördern auch Innovationen in der Branche.“
    https://safety.google/intl/de/security/security-leadership/

    FLoC „Google hat seine neue Technologie Federated Learning of Cohorts (FLoC) nun gestartet. Mit dieser sollen die unbeliebten Tracking-Cookies verschwinden und trotzdem zielgerichtete Werbeschaltungen möglich sein. Statt einen einzelnen Nutzer durch das Netz zu verfolgen und seine Interessen aus diesem Profil abzuleiten, sollen die User nun größeren Interessens-Gruppen zugeordnet werden.“
    https://datenschutzbeauftragter-hamburg.de/2021/04/googles-cookie-ersatz-floc-aus-datenschutzsicht-eine-verbesserung/

    https://winfuture.de/videos/Internet/FLoC-So-funktioniert-Googles-Ersatz-zum-unbeliebten-Tracking-Cookie-22581.html

    Zeitgenössisches über „Suchmaschinen“ – was davon gilt heute noch?
    http://www.kommdesign.de/links/suchmaschinen.htm

    kaesekuchen.de gibt es wirklich
    In dieser Folge wird mehrfach die kaesekuchen.de erwähnt. Als URL spontan während der Aufnahme entstanden, um Methoden der Suche zu illustrieren.
    Nun: Es gibt diese Seite wirklich. Ist eine nicht kommerzielle Seite, auf der man viele Käsekuchen Rezepte findet. Der Besitzer (aus Bonn) der Seite hat uns die Verlinkung gestattet. Wie klein ist die Welt…
  • Experimente, AB-Tests, Multivariantentests – die normative Kraft des Faktischen

    Experimente, AB-Tests, Multivariantentests – die normative Kraft des Faktischen

    (S1/E05) Abermals werfen wir einen Blick unter die Haube und hinter die Pixel. Diesmal geht es um eine sehr weit verbreitete Technik oder Methode, die von vielen Firmen genutzt wird, um Web-Auftritte, Spiele, Formulare, Shop-Systeme, aber auch E-Mail-Newsletter oder Anzeigen im Internet zu optimieren. Experimente – im Jargon der Online-Marketing-Profis werden sie auch „AB-Testing“ oder „Multivariantentests“ genannt.

    Während sich normale Menschen vielleicht gerade noch an die Experimente aus dem Chemie und Physik-Unterricht erinnern, die sozusagen in Handarbeit hergestellt wurden, werden die umfangreichen Online-Experimente, von denen wir in dieser Folge berichten, am Fließband von Webservern, Algorithmen und Skripten gemacht und teils an tausenden Besucher*innen ausprobiert. Von hier ist es dann nicht mehr weit zu einem Internet, das ganz von selbst auf die Informationsbedürfnisse spezieller Zielgruppen optimierte Echokammern hervorbringt…

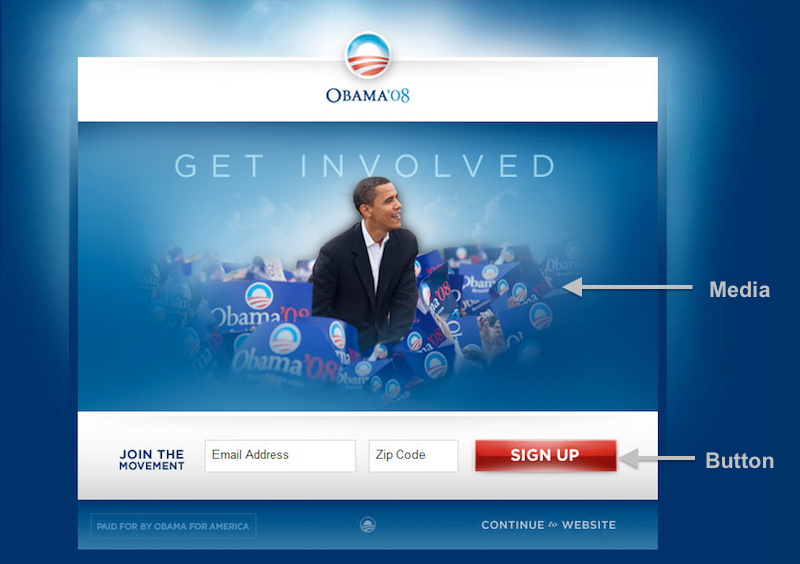
    Eine besondere Rolle in der heutigen Folge spielt ein Experiment, das die Fa. „Optimizely“ für die Wahlkampagne von Barack Obama im Jahr 2012 durchgeführt hat. Das folgende Bild zeigt das Objekt, mit dem experimentiert wurde:

    Bildausschnitt der Kampagnen-Website von Barack Obama 2012
    Standard-Version des Screen-Elements, das in 24 unterschiedlichen Versionen gezeigt wurde.
    Bildquelle: http://blog.optimizely.com/wp-content/uploads/2010/11/Obama_Homepage_original.png

    Was damit genau gemacht wurde? Das erzählen wir im Podcast…

    Die Geschichte zum Beitragsbild

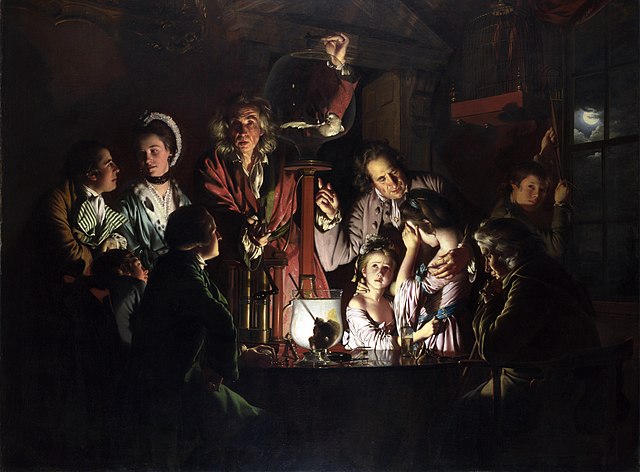
    Das 18. Jahrhundert war eine Zeit des Aufbruchs in den Naturwissenschaften. In ganz Europa, vorwiegend England, Frankreich und Deutschland, machten sich Wissenschaftler daran, die Gesetze der Physik und die Geheimnisse des Lebens zu ergründen. Nicht wenige waren Aristokraten, wie Robert Boyle , der es sich als Sohn einer der reichsten Familien Englands leisten konnte, allerlei Gerätschaften für Experimente anzuschaffen und diese auch zu nutzen. Ihm gelang der unzweifelhafte Nachweis, dass Lebewesen Luft zum Atmen brauchen! Die Methode wirkt aus heutiger Sicht mehr als grausam: Versuchstiere wurden in Vakuum-Glasglocken eingesperrt, aus denen die Luft herausgepumpt werden konnte…

    Die Szene und das Ergebnis möchten wir uns lieber nicht ausmalen – ganz im Gegensatz zu dem englischen Maler Joseph Wright of Durby, der etwa ein Jahrhundert später genau dieses Experiment in einem berühmten Kerzenlicht-Bild darstellte. Ein Papagei wird von einem fanatisch quasi in die Kamera blickenden Naturforscher in einer Glasglocke erstickt, während die umstehenden Personen sehr unterschiedlich reagieren – die meisten eigenartigerweise ziemlich desinteressiert. Es gibt Autoren, die dieses Desinteresse als symbolhaften Ausdruck der beginnenden Gefühllosigkeit der Menschen gegenüber der Schöpfung interpretieren. Wie spätere Generationen unsere modernen Internet-Experimente bewerten werden, das ist natürlich nicht sicher vorherzusagen. Aber wir haben einen Verdacht, dass es sich vielleicht ähnlich fremdartig ausnehmen wird…

    Bildquelle: https://commons.wikimedia.org/wiki/File:An_Experiment_on_a_Bird_in_an_Air_Pump_by_Joseph_Wright_of_Derby,_1768.jpg

    Quellen:

  • Wir wissen nicht, was sie tun: Maschinelle Autokorrekturen

    Wir wissen nicht, was sie tun: Maschinelle Autokorrekturen

    (Folge 4, 02.07.2021) Autokorrekturen können lustig, lästig und nützlich sein. Aber was passiert, wenn ein Industrie-Scanner Konstruktionszeichnungen, Steuererklärungen oder Dokumente eigenmächtig verändert? Wie kommt es, dass dieser Software Fehler auch Jahre nach der Entdeckung immer noch sein Unwesen in den Geräten treibt?

    Ausgangspunkt dieser Folge sind Scanner, die „halluzinieren“ und Muster erkennen, die es so nicht gibt. Wir begeben uns auf die Spuren von scheinbar intelligenten Produkten und berichten über die Fallstricke der digitalen Transformation unseres Lebens.

    Denn als Nutzer digitalisierter Produkte wie Smartphones, Autos oder Scannern wissen die meisten von uns nicht, wie genau diese funktionieren, welche Algorithmen (Rechenregeln) uns gerade ihre Ergebnisse präsentieren oder in von uns anders gewollte Abläufe eingreifen.

    Und wir kommen auf den Hund – und erfahren, was die Versuche, die unterschiedlichen Hunderassen maschinell auseinander zu halten, mit Scannern, Autos und Smartphones zu tun haben.

    Bildquelle

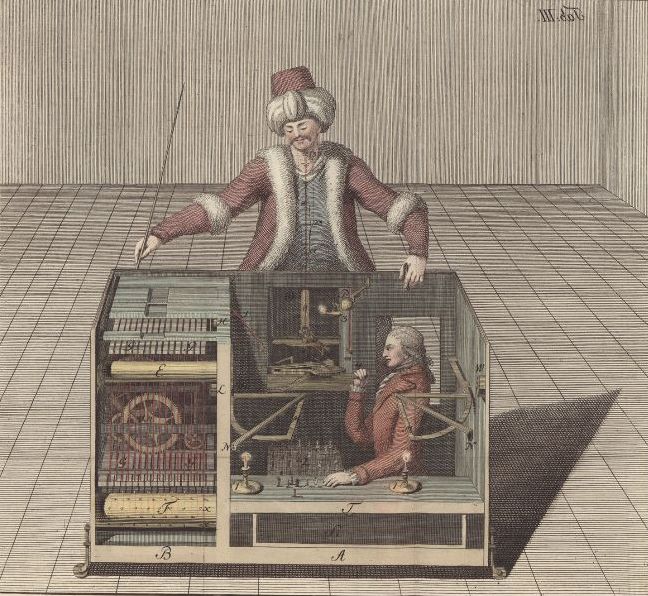
    Das Beitragsbild zeigt ein Wunderwerk der Technik aus dem 18. Jhd. Sein Erfinder, Wolfgang von Kempelen erzeugte bei den Zuschauern den Eindruck, dass dieser Apparat tatsächlich Schach spielen könne. In Wirklichkeit verbarg sich in der Maschine ein Schachmeister, der eine höchst komplexe Maschine bediente. Der Schwindel flog erst spät auf, die Algorithmen waren tief im System verborgen.

    https://commons.wikimedia.org/wiki/File:Racknitz_-_The_Turk_3.jpg

    Quellen

  • Dark patterns, oder: Der kochende Frosch

    Dark patterns, oder: Der kochende Frosch

    (S1/E03) Wir machen in diesem Beitrag auf ein Phänomen aufmerksam, das uns im Web, in Apps, in (Online-) Spielen in sehr verschiedenen Erscheinungsformen begegnet, aber eine gemeinsame Wurzel hat: „Dark Patterns“ sind mehr oder weniger offene Taktiken, mit denen Informationsanbieter, Shops, Spiele-Anbieter ihr Publikum zu bestimmten Verhaltensweisen leiten, überreden, manipulieren, zwingen wollen.

    Sie folgen dabei ihren eigenen Interessen, und leider sind sie nicht selten erfolgreich: Wir kaufen, bestellen, übergeben persönliche Daten, erteilen Genehmigungen, treffen Entscheidungen nicht so, sondern anders, klicken nicht diesen, sondern jenen Button. Im Hintergrund sind hier Erkenntnisse der Psychologie in der Geschmacksrichtung „Verhaltensökonomie“, die auf teils sehr offensichtlichen, unter Umständen aber auch auf subtilen Effekten und Mechanismen beruhen.

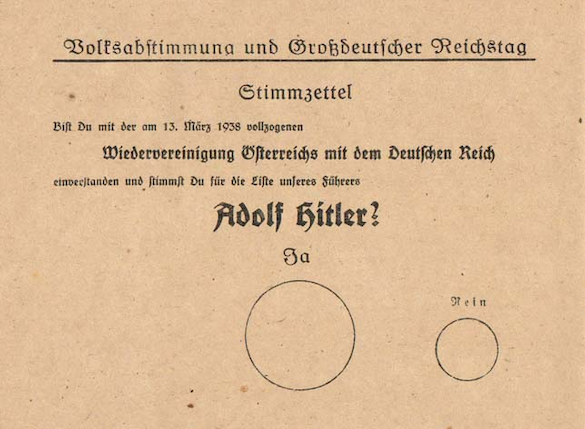
    Der Stimmzettel zum Anschluss Österreichs an das Deutsche Reich
    Der Stimmzettel zum Anschluss Österreichs an das Deutsche Reich ist sicher nicht das erste historische Dark Pattern, aber eines, das wirklich rabenschwarz ist. Wahlen müssen frei und unbeeinflusst stattfinden – natürlich. Doch hier gibt es keine freie, sondern eine richtige und eine falsche Entscheidung!
    Bildquelle: https://commons.wikimedia.org/wiki/File:Stimmzettel-Anschluss.jpg

    Das Arsenal der Taktiken, Tricks und Täuschungen im Web, in Spielen, Shops und Apps ist groß, vielfältig und psychologisch so interessant, dass wir dem Thema sicherlich mehr als einen Beitrag widmen werden.

    …und was das mit kochenden Fröschen zu tun hat? Das verraten wir hier natürlich nicht. Hört Euch / hören Sie sich den Beitrag an!

    Die Geschichte zum Beitragsbild:

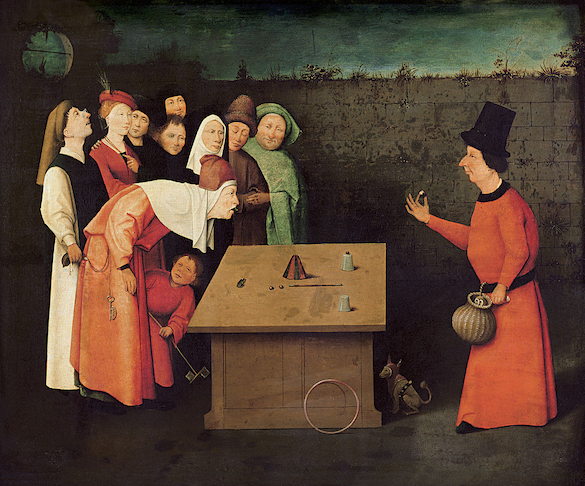
    Betrug und Täuschung sind sicherlich so alt wie die Menschheit. Das Bild zu unserem Blog-Beitrag zeigt ein berühmtes Gemälde des niederländischen Malers Hieronymus Bosch. Man sieht ein „Dark Pattern“ aus dem 15. Jahrhundert, in dem ein listiger Gaukler sein Publikum ablenkt, sodass sein Komplize das Publikum hinterrücks um seine sauer verdienten Gulden erleichtern kann. Auch hier gelten die Gesetze der Psychologie der Dark Patterns.
    (a) Sorge dafür, dass Dein Publikum über spektakuläre Effekte und Inhalte Bauklötze staunt.
    (b) Versetze es in einen Zustand reduzierter Ablenkbarkeit.
    (c) Nutze die hierdurch entstehenden Möglichkeiten…!

    Quellen:

    • Die Referenz zum Thema Dark Patterns schlechthin stammt von dem Designberater Harry Brignull, der übrigens nicht ganz zufällig einen Ph.D. (einen Doktorgrad) in Cognitive Science hat.
      aus „darkpatterns.org“ wurde „deceptive.design
    • Über den lustigen Aprilscherz der Firma Gamestation mit den 7.500 über AGBs verkauften Seelen, der im Podcast erwähnt wird, kann man u.a. in dieser Meldung auf golem.de nachlesen:
      https://www.golem.de/1004/74564.html
    • Wer sich für die Geschichte rund um den kochenden Frosch interessiert, findet in der „Wikipedia“ den besten Ausgangpunkt für eine Recherche. Mit etwas Geduld findet man von hier aus sogar die Originalarbeiten aus dem 19. Jahrhundert, in denen – angeblich – Frösche gekocht wurden.
      https://en.wikipedia.org/wiki/Boiling_frog

  • Den Fährtenlesern auf der Spur

    Den Fährtenlesern auf der Spur

    (S1/E02)  Am 27. Januar 2018 um 19:24 Ortszeit teilte der 20 jährige Nathan Ruser aus Canbera, Australien, in einem Tweet brandgefährliche Informationen: Auf der frei zugänglichen Landkarte einer Fitness App sind geheime US Militär Standorte deutlich zu identifizieren. Vermeintlich harmlose, anonymisierte Bewegungsdaten zeichnen ein Bild von Laufwegen und Strassennetzen.

    In dieser Folge nimmt …achwas?! selbst die Spur der (un-) heimlichen Fährtenleser auf, die in unseren Apps und im Web werkeln. Wir erzählen, wie wenig es braucht, um sehr viel über uns und unser Leben zu erfahren.

    Unsere Spurenaufnahme führt uns weiter auf die Fährte des kalifornischen Unternehmens SafeGraph*, das wahre Informationsschätze aus wenigen anonymisierten Geolokationen (also Ortung eines Smartphones mit Zeit und Standort) unter Wahrung des strengen kalifornischen Datenschutzes macht. Wie passiert das, ohne irgendwelche persönlichen Daten abzufragen? Wie macht SafeGraph* das, dass die Käufer der Datensätze trotzdem erfahren können, wo Menschen wohnen, einkaufen, ihre Freizeit verbringen, ob sie italienische Restaurants oder den Schnellimbiss bevorzugen, welche Automarke sie fahren – oder ob eher Frauen oder Männer öffentliche Verkehrsmittel nutzen, um ins Büro oder die Fabrik zu kommen?

    Manchmal werden diese Infromationen nicht gekauft, sondern „ge-leakt“, kommen über eine undichte Stelle (Leak) an interessierte Kreise. Ein solches Leak ereilte die Zuhörer der Brand-Rede Donald Trumps vor dem Capitol. Als am 6.1.2021 hunderte Menschen das Capitol erstürmten, hinterließen ihre Smartphones Datenspuren und „petzten“ eine Menge sehr persönlicher Informationen** an die New York Times.

    Anmerkungen :
    *SafeGraph ist nicht im Geltungsbereich der DSGVO (EU) tätig.
    ** Ein Leak dieser Art an die Presse wird durch unsere Datenschutzgesetze und die DSGVO verhindert. Die Nutzung von Geolokationen durch Polizei und Staatsanwaltschaft bedarf eines Richterlichen Beschlusses.

    Die Geschichte zum Beitragsbild: 

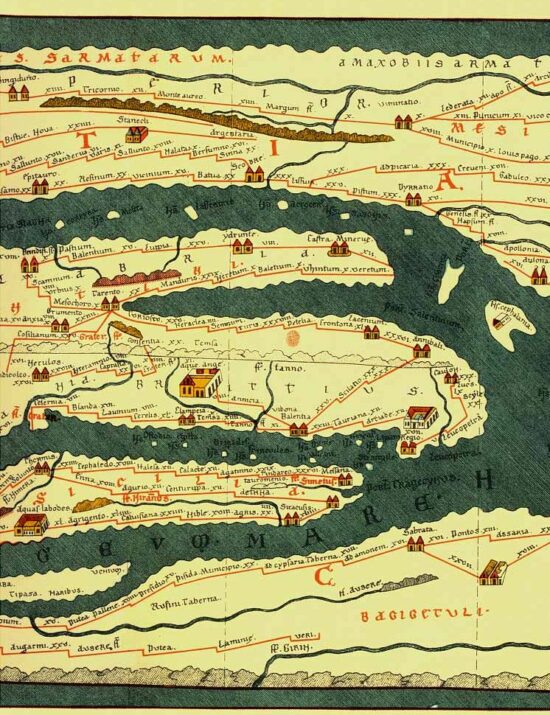
    Wo bin ich – wohin muss ich laufen, reiten, fahren, gehen, um mein Ziel zu erreichen? Unser Wunsch nach Orientierung über unsere Sinne (Auge, Ohr, Tastsinn, Gleichgewichtssinn) und unseres Gedächtnisses bekam schon früh Prothesen durch Zeichnungen und Landkarten. Eine der umfassendsten Landkarten war die Tabula Peutingeriana, deren Original um 345 n.Chr. erstellt wurde. Sie wurde als Wege-, Orts- und Strassenverzeichnis des gesamten Römischen Reichs gezeichnet. Landmarken und Strassen sind nicht massstabgetreu, sondern eher wie die Schemazeichnungen von „London Tube“ oder „Metro Paris“ angelegt.

    Bildquelle: https://de.wikipedia.org/wiki/Tabula_Peutingeriana

    Quellen

    Nathans’s Tweet
    vom 27.1.2018 über geheimnisvolle Spuren auf der Landkarte einer Fitness-App https://twitter.com/Nrg8000/status/957326421684207616

    Mehr über Nathan Ruser
    https://money.cnn.com/2018/01/29/technology/strava-nathan-ruser/index.html

    https://taz.de/Menschenrechtsverletzungen-in-China/!5735542/

    Die Karte der Fitness App STRAVA
    https://www.strava.com/heatmap#7.00/-120.90000/38.36000/hot/allDie Fitness App STRAVA weisst darauf hin, dass die Nutzung als Mapping Tool optional ist.

    SafeGraph Inc. – brilliant, wie man aus Standort, Zeit und Offenen Daten Informationen ernten kann.
    https://www.safegraph.com/blog

    Please Rob Me: Das Projekt ist fast schon als historisch zu bezeichnen (aus dem Jahr 2011), das Problem der Privatheit des eigenen Standorts ist aber heute so aktuell wie damals. Auf der Seite sind durchaus lesenswerte Artikel zum Thema „Locational Privacy“ verlinkt. https://pleaserobme.com/

    New York Times: They Stormed the Capitol. Their Apps Tracked Them.
    Times Opinion was able to identify individuals from a trove of leaked smartphone location data.     https://www.nytimes.com/2021/02/05/opinion/capitol-attack-cellphone-data.html?sara_ecid=nl_upd_1jtzCCtmxpVo9GAZr2b4X8GquyeAc9&nlid=h0s9e6sz

    Bonus Material:

    SPIEGEL ONLINE
    Wo die schöne Welt der neuen Mobilität endet

    Carsharing-Anbieter wie WeShare, Share Now oder Miles meiden ärmere Stadtteile. Dafür fluten sie mit ihren Wagen angesagte Innenstadtviertel – und verschärfen dort manche Verkehrsprobleme, anstatt sie zu lösen.

    https://www.spiegel.de/auto/carsharing-share-now-weshare-miles-und-co-wo-die-welt-der-neuen-mobilitaet-endet-a-5c431f05-95b5-46d9-a24d-27e3dfda0d3c

  • Psychographisches Targeting: Der „Cambridge Analytica“ Skandal

    Psychographisches Targeting: Der „Cambridge Analytica“ Skandal

    (S1/E01) 2010 öffnete Facebook eine Schnittstelle, über die Dritte Profile und Daten der Benutzer*innen aus der Social Media Plattform auslesen konnten. Wenige Jahre später machen sich Psycholog*innen und Data Scientists daran zu demonstrieren, was man anrichten kann, wenn man Persönlichkeitstests („Psychographie“) und Methoden des Online-Marketings („Targeting“) an einer solchen Schnittstelle kombiniert – mit Daten aus 50 Millionen geklauter Profile… Data Science meets Psychology.

    Das Ergebnis der in dem Skandal angewendeten Methoden war im wahrsten Sinn des Wortes weltbewegend, nämlich der „Brexit“ und die Wahl von Donald Trump zum amerikanischen Präsidenten – möglicherweise. Denn: ob und wie stark diese Jahrhundert-Entscheidungen wirklich durch psychografisches Targeting als Propagandawerkzeug beeinflusst waren, wird wahrscheinlich nie ganz aufzuklären sein. In wissenschaftlichen Studien wurde allerdings klar belegt, dass die von dem Unternehmen angebotenen Dienstleistungen, die auf der Durchleuchtung der Persönlichkeit von Personen beruhen sollten, durchaus funktionieren.

    Wir werden über diese Forschungsarbeiten in späteren Beiträgen noch berichten, aber in jedem Fall ist der „Cambridge Analytica Skandal“ eine wahrhaft würdige Geschichte zum Auftakt unseres Podcasts.

    Quellen

    Wer zum Thema Cambridge Analytica recherchiert, kann ob der Menge der Treffer leicht verzweifeln. Die besten Beiträge, die wir zum Einstieg in das Thema empfehlen können, sind diese:

    Die Geschichte zum Beitragsbild:

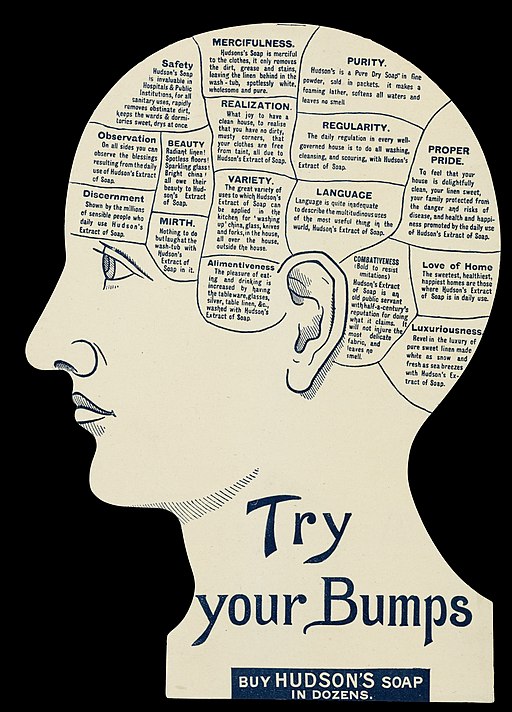
    Die Sehnsucht der Marketing-Spezialisten, aus Hirnforschung und Psychologie magische Rezepte für den Abverkauf von Waren und Dienstleistungen zu entwickeln, wird heute gerne in Neuro-Blabla-Modelle eingepackt. Aber sie ist schon alt. Psychographie und Werbung werden beispielsweise in diesem historischen Poster der Firma „Hudsons Soap“ verknüpft. Es nimmt Bezug auf eine im 19. Jahrhundert weit verbreitete – übrigens völlig falsche – Vorstellung, der zufolge verschiedene Charaktermerkmale in bestimmten Hirnarealen lokalisiert sein sollten. Hiermit eng verbunden war die – übrigens ebenso falsche – Idee, dass man aus der Schädelform auf Charakter von Personen schlussfolgern könnte. „Phrenologie“ war der Name dieser Lehrmeinung, die – ungeachtet ihrer Popularität in der Wissenschaft – nicht mehr als eben dies war (also eine Meinung). In unserem Beitragsbild sind es die Eigenschaften eines wahrhaft wundervollen Seifenpulvers, die mit durchaus ironischem Unterton in unterschiedlichen Hirnarealen angesiedelt werden.
    Bildquelle: https://wellcomecollection.org/works/gs3adbae